AIエージェント
2026年、ドイツ・ボンで開催されたCONTACT Software主催の「CONTACT Open World 2026」。CONTACT Softwareのパートナーとして日本市場で活動するGBSも現地に参加し、基調講演や各種セッションを聴講しました。
今回のOpen Worldで特に印象的だったのは、単に「AI機能が追加された」ということではありません。CONTACT Softwareが、従来のPLMを中心とした製品群から、AI、IoT、デジタルツイン、製造、サービスまでをつなぐ統合プラットフォームとして、その位置付けをさらに明確にしていることです。
AIが設計案や変更案を生成できるようになるほど、「どの情報をもとに生成されたのか」「どの製品・構成に対する提案なのか」「誰が評価・承認したのか」といった製品情報の文脈とトレーサビリティが重要になります。
本記事では、CONTACT Open World 2026で示された方向性を、日本の製造業におけるPLM、AI活用、Smart Factory、Digital Serviceという観点から整理します。
CONTACT Elementsは「個別製品」から共通プラットフォームへ
CONTACT Elementsを中心としたプラットフォーム戦略
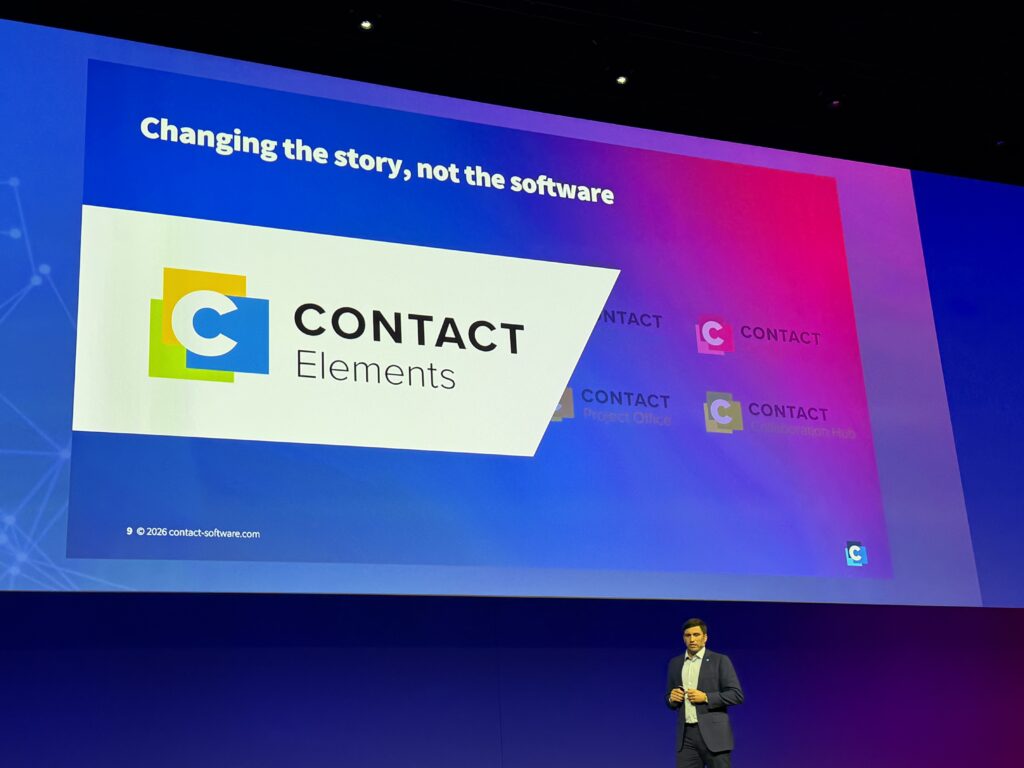
CONTACT Softwareの戦略の中心にあるのが、「CONTACT Elements」という共通プラットフォームを軸に、これまでの製品・機能を再整理する考え方です。
従来、CONTACT Softwareの製品群は、CIM DatabaseによるPLM、Project Officeによるプロジェクト管理、Elements for IoTによるIoTなど、それぞれの製品・ソリューションとして説明されることが多くありました。
今後は、これらをCONTACT Elementsという共通プラットフォーム上のBuilding Blocksとして整理し、業界や企業ごとの事前設定と、個別要件に対応する拡張性を組み合わせて提供していく方向が示されています。
講演では、この考え方を象徴する表現として「Changing the story, not the software」という言葉が使われました。ソフトウェアそのものを全面的に作り替えるのではなく、CONTACT Elementsを中心に、市場への見せ方や提供方法を再構成していくという考え方です。
EngineeringとPLMを核に、製造・IoT・サービスへ広がる
CONTACT Elementsは、EngineeringとPLMを中核にしながら、製品ライフサイクルの周辺領域へ活用範囲を広げています。
- Manufacturing:製造業務、生産管理、MES等との連携
- IoT:センサーデータ、デバイス管理、接続製品
- Service:保全管理、顧客サービス、アフターサービス
- Systems Engineering:要求、アーキテクチャ、テスト、トレーサビリティ
- AI / Automation:Industrial AI、AIエージェント、業務自動化
こうした領域を横断して活用するため、講演ではデータの標準化、API、Clean Data、そしてContext(文脈)の重要性が繰り返し取り上げられていました。
CONTACT Softwareについて詳しく知りたい方へ
CONTACT ElementsやCIM Database、BOM管理、設計変更管理など、CONTACT Softwareの製品・導入支援については、製品紹介ページで詳しくご紹介しています。
CONTACT Softwareの詳細を見る →
Industrial AI:「質問するAI」から「業務を動かすAI」へ
Ask、Suggest / Understand、Actという3段階
CONTACT Softwareが示すIndustrial AIの方向性は、大きく3つの段階に整理できます。
- Ask:エンジニアやビジネスユーザーがAIへ質問する
- Suggest / Understand:AIが業務や製品の状況を理解し、候補や提案を示す
- Act:制御された範囲の中でAIが処理や業務アクションを実行する
これは、AIが単なる質問への回答ツールから、エンジニアリング業務を支援する存在へ発展していく方向を示しています。
一方で、AIが無制限に自律判断するという考え方ではありません。講演では、Human in the Loop、人による理解・確認、Audit Trail(監査証跡)を組み込むことが重要な設計原則として示されていました。
AIに必要なのは「データ量」だけではなくEngineering Context
CONTACT Fourier AIを含むIndustrial AIで重要になるのが、エンジニアリングデータのContextです。
AIが製造業の業務で有用な提案をするためには、単に大量の文書や数値を与えるだけでは十分ではありません。
- どの製品に関するデータなのか
- どの構成・バージョンなのか
- どのプロジェクトに属するのか
- どの顧客要求・製品要求に対応するのか
- どの業務プロセスの情報なのか
- 過去にどのような判断が行われたのか
といった情報同士の関係が必要になります。
その意味でAI時代のPLMには、製品情報を単に保管するだけでなく、AIが利用できる正しいProduct Contextを提供する情報基盤としての役割が求められるようになります。
AI時代にはPLMの役割そのものが変わる
確定した製品情報と、AIが生成する候補を分けて管理する
今回の講演で特に印象的だったのが、AIによって設計案や変更案を生成するコストが下がるほど、エンジニアリングのボトルネックが「作ること」から「どの案を採用するかを評価し、選択し、承認すること」へ移っていくという考え方です。
これまでのPLMでは、正式に承認された図面、BOM、仕様、文書などを、現在の製品を表す確定情報として管理してきました。CONTACT Softwareの講演では、こうした正式な製品情報を「Product Truth」と表現していました。
一方、生成AIやAIエージェントを利用すると、一つの要求に対して複数の設計案や変更案、対応方法を短時間で生成できるようになります。これらは、まだ採用が決まっていない「製品の将来候補」であり、講演では「Possible Futures」という言葉で整理されていました。
重要なのは、AIが生成した候補を、そのまま正式な製品情報として扱わないことです。検討中の設計案や変更案と、承認済みのBOMや仕様が同じように扱われると、どれが現在有効な製品情報なのか分からなくなってしまいます。
AI時代のPLMには、「確定した製品情報」と「これから評価・判断する候補」を明確に分けながら、その候補がどの要求や製品構成から生まれ、どのような検証・承認を経て正式情報になったのかを追跡できることが、これまで以上に重要になります。
AIが候補を作り、PLMが判断プロセスを支える
AIが変更案を生成したとしても、それを実際の製品変更として採用するには、複数の観点から確認する必要があります。
- 要求への適合性:顧客要求や製品要求を満たしているか
- 影響分析:部品、図面、ソフトウェア、製造プロセスなどへどのような影響があるか
- 検証:品質、安全性、テスト等に問題がないか
- 意思決定の根拠:なぜその案を採用したのか
- トレーサビリティ:どの情報をもとに、いつ、どのAIが提案し、誰が承認したのか
AI時代のPLMは、「製品が現在どうなっているか」を記録するだけでなく、製品をどのように変えるべきかという判断プロセスを支える基盤へ役割を広げていくと考えられます。
Fourier AIはエンジニアリング業務へどう組み込まれるのか
単なる「PLMの横にあるチャットAI」ではない
CONTACT Fourier AIの事例を見ると、目指しているものはPLM画面の横にチャット機能を追加することではありません。
PLMに蓄積された製品情報、要求、文書、BOM、過去案件などのエンジニアリングナレッジを、次の業務へ再利用する仕組みとしてAIを組み込むことが特徴です。
大手電機・接続機器メーカー:製品属性入力とETO類似案件検索
ある大手電機・接続機器メーカーでは、Fourier AIを利用した製品属性入力支援が紹介されました。
技術資料や仕様書からAIが情報を抽出し、例えば次のような属性の候補をPrefill(事前入力)します。
- 定格電圧
- 定格電流
- 装着方式
- 筐体色
- 動作温度範囲
重要なのは、AIがそのまま正式データとして登録するのではなく、AIによる提案 → 人による確認 → 正式登録という流れになっていることです。
さらにETO(Engineer to Order:受注設計)の領域では、新しい顧客要求をAIが分析し、過去の類似プロジェクト、要求、関連BOMなどを検索・提案するユースケースも紹介されました。
過去の設計資産を再利用できる可能性を早い段階で判断できれば、見積や設計の出発点を効率化できます。
大手産業設備メーカー:PLM移行支援と3D類似検索
別の大手産業設備メーカーからは、PLM移行時のデータチェックや3D設計データ活用へのAI適用が紹介されました。
既存システムからPLMへデータを移行する際には、データの不整合、欠落、関連情報の確認など、多くの作業が必要になります。
紹介されたアプローチでは、AIが次のような作業を支援します。
- データ不整合の検査
- 影響を受けるドキュメントの特定
- 修正が必要な項目の提案
ここでもAIによる無条件の自動修正ではなく、AIが候補を示し、人が確認したうえで反映するという考え方が採られています。
また、CAD形状の幾何学的特徴をVector化し、名称や分類だけに依存せず類似した3D部品を検索する技術も紹介されました。既存部品の再利用や重複設計の抑制につながる可能性があります。
CONTACTの次世代ロードマップ:Fourier AI、XLM、PLM拡張
CONTACT Open World 2026では、今後のロードマップも紹介されました。
ここでは、現在利用可能な機能、計画中の機能、将来の研究・構想を区別して見ることが重要です。
Fourier AI:今後計画されている方向
Fourier AIについては、今後の方向として次のようなテーマが紹介されました。
- Agentic Authoring:AIによる複数ステップの作業支援・自動化
- Event-driven Agents:システムイベントをきっかけにしたAI処理
- Multi-Agent Orchestration:複数AIエージェントの連携
- Geometry / Design Intelligence:CAD形状・設計データに対するAI分析
また、Generative CADについても、将来に向けた研究テーマとして紹介されました。AIが要求や設計条件をもとにCADモデルや複数の設計候補を生成するようになれば、「設計案を作ること」以上に、それらをどう評価し、選択し、正式な製品情報へつなげるかが重要になります。これは、今回紹介された「Product Truth」と「Possible Futures」という考え方にもつながるテーマです。
XLM:PLMをSystems Engineeringへ拡張する
今回のロードマップで注目されたもう一つのテーマが、XLM(Extended Lifecycle Management)です。
XLMは単独の要求管理ツールではなく、要求からアーキテクチャ、各Engineering Discipline、テストまでをライフサイクルとしてつなぐ構想です。
- Requirements Management:要求の定義・管理
- Architecture Management:システムアーキテクチャ管理
- Mechanics / Electronics / Electrical / Software:複数分野の情報連携
- Test Management:テスト計画・実行・結果管理
- Traceability:要求から設計、テストまでの追跡
講演では「PLM is the basis for XLM」という考え方が示されました。XLMがPLMを置き換えるというより、PLMを製品情報の基盤として、Systems Engineering全体へ対象範囲を広げる方向です。
PLM領域:現在提供中の主な機能
- Engineering Change Management 2.0:Problem Report、Change Request、Change Orderを独立したオブジェクトとして扱う変更管理
- Version Control / Variant Management:製品仕様やバリアントを含む構成管理
- PDF Viewing / Redlining:PDF表示・注釈機能。Optional Componentとして提供
- Digital Signing:デジタル署名・認証関連機能の刷新
PLM領域:計画中として紹介された主な機能
- M-BOM 3D Visualization:M-BOMへ再構成した製品構造での3D表示
- Product Structure Templates & Placeholders:標準製品構造とPlaceholder、Ruleを活用したCTO / ETO支援
- PLM-ERP統合の強化:ERP連携技術や標準連携の拡張
- Intercompany Collaboration:顧客、サプライヤー、協力会社等とのシステム上での協業
Configuration Managementについても、今後のPLMを構成する重要なテーマの一つとして取り上げられました。
PLMでBOM・設計変更・製造情報をどうつなぐか
CIM Databaseでは、BOM、図面、文書、設計変更などの製品情報を関連付け、設計から製造・サービスまでをつなぐ製品情報基盤を構築できます。
CIM Databaseの詳細を見る →
設計から工場へ:Smart Factoryに広がるCONTACT Elements
大手鍛造部品メーカー:工場全体のデジタル化
CONTACT Elementsの適用範囲は、設計部門だけではありません。
ある大手鍛造部品メーカーの事例では、工場領域における幅広いデジタル活用が紹介されました。
- 生産状況を可視化するダッシュボード
- 品質管理
- 原材料管理
- 生産計画・進捗の動的な管理
- 作業者向けダッシュボード
- 作業者のスキル管理・教育
- 設備保全のデジタル化
- 金型管理
- 予知保全
- AI画像認識による検査・監視
- デジタルツイン
ここで重要なのは、個別の業務を単にデジタル化しているのではなく、生産・品質・設備・作業者など、工場で発生するさまざまな情報をつなぎ、製造現場全体の改善に活用しようとしていることです。
IoTセンサーから取得した設備データを、製造、品質、材料、保全などの業務情報へつなぎ、さらにAIやPLMと連携する方向が示されています。
大手製造企業:小さなIoTユースケースから保全業務へ
Smart Factoryは、必ずしも工場全体を一度にデジタル化する必要はありません。
ある大手製造企業では、製造設備を支えるCooling / Filtering Systemの状態監視からIoT活用を開始した事例が紹介されました。
特に興味深いのは、単にセンサーデータをダッシュボードへ表示するだけではなく、
Sensor → IoT Event → Service Case生成 → Maintenance Task
という流れで、設備状態の変化を実際の保全業務へつないでいる点です。
IoTの価値は「見える化」だけではなく、異常やイベントを、誰が何をするのかという業務プロセスへ接続することで高まります。
GBSのIoT導入支援について詳しく見る →
製品を売るだけでなく「成果」を提供するDigital Serviceへ
ComponentからSystem、そしてOutcomeへ
Open Worldでは、製造業のビジネスモデルについても議論されました。
顧客が本当に必要としているのは、必ずしも機械や部品そのものではありません。
- 生産量
- 品質
- 設備の稼働率
- ダウンタイムの削減
- 効率性
- Total Cost of Ownership
といった業務上の成果(Outcome)が、本来の顧客価値です。
こうした成果を継続的に提供するためには、Connected Product、Data & AI、Digital Platform、Serviceを組み合わせる必要があります。
大手駆動機器メーカー:Engineering Knowledgeを顧客サービスへ
ある大手駆動機器メーカーからは、PLMに蓄積されたEngineering Knowledgeを、社内エンジニアだけでなく顧客の製品選定にも利用するDigital Sales Serviceの考え方が紹介されました。
顧客が要求条件を入力すると、エンジニアリング情報をもとに駆動システムのSizing、Configuration、Quotationへつなげていきます。
つまりPLMに蓄積した製品知識を、製品開発だけではなく、顧客が製品を選択・判断する段階から活用するという考え方です。
Knowledge Graphを利用し、多数の技術文書を単なるPDFの集合としてではなく、必要な情報とContextを検索・利用できる形へ変える取り組みも紹介されました。
包装機械メーカー:IoTを顧客向けSubscription Serviceへ
包装機械メーカーの事例では、CONTACTのIoT基盤を自社顧客向けDigital Serviceとして利用する取り組みが紹介されました。
顧客へ提供する情報には、例えば次のようなものがあります。
- OEE
- Production Data
- Alarm / Alert
- Reject Data
- Machine Documentation
特徴的なのは、Alarm Listから関連するMachine Documentationへ直接アクセスし、異常発生 → 状況確認 → 必要な情報の参照という業務をつなげていることです。
将来的には、蓄積したHistorical Dataを活用した分析、顧客サポート、Maintenance Management等への拡張も計画されています。
GBSがOpen World 2026から感じたこと:AI時代にPLMが果たす役割
AIは大量の候補を作れる。しかし正式な製品変更には判断が必要
今回のOpen Worldを通じて見えてきたのは、「AIが普及すればPLMが不要になる」という方向ではありません。
AIは今後、次のような作業を支援できるようになると考えられます。
- 顧客要求を読み取る
- 設計候補を生成する
- BOM候補を提示する
- 過去の類似案件を探す
- 設計変更案を提案する
- テストケースの作成を支援する
しかし製造業では、「良さそうな答え」が生成されるだけでは、実際の製品情報として利用することはできません。
その提案が、
- どの製品のものなのか
- どの構成・バージョンに対するものなのか
- どの要求から生まれたものなのか
- どの部品や製造工程に影響するのか
- 誰が、いつ、どのような根拠で承認したのか
を管理する必要があります。
そのため、AI時代にはPLMが、AIへProduct Contextを提供すると同時に、AIが生み出した提案を正式なEngineering Processへ接続する基盤として重要になっていくとGBSでは考えています。
日本の製造業で考えるべき4つのポイント
CONTACT ElementsやAI活用を日本の製造業へ展開する際には、AI機能だけを先に導入するのではなく、次の観点から情報基盤を整えることが重要です。
- Clean DataとContextの整備
製品属性、BOM、Revision、要求、プロジェクト等の情報を整理し、相互の関係を明確にする。
- Engineering Change Processの整理
AIが生成した候補と正式なProduct Truthを区別し、評価・検証・承認するプロセスを明確にする。
- 製造・保全・サービスへの拡張
PLMを設計部門だけのシステムと考えず、必要に応じてERP、MES、IoT、サービス領域との役割分担を整理する。
- Digital Threadの設計
設計 → 製造 → 稼働 → サービス → フィードバック → 次の開発という情報の流れをつなぐ。
まとめ:AI、PLM、製造、サービスを一つのDigital Threadでつなぐ
CONTACT Open World 2026から見えてきた最大の変化は、特定の一つの新機能ではありません。
製品企画 → 設計 → PLM → 製造 → IoT・稼働 → 保全・サービス → Customer Feedback → 次の製品開発
という製品ライフサイクル全体をDigital Threadとしてつなぎ、その情報をAIも利用できるようにする方向が、より明確になってきています。
CONTACT Elements、Fourier AI、XLM、Smart Factory、Digital Serviceは、それぞれ別々のテーマに見えます。しかし、すべてをつなぐ共通点は製品と業務のContextを維持しながら、ライフサイクル全体の情報を利用することです。
AIが大量の候補を生成できるようになるほど、正確な製品情報、構成管理、トレーサビリティ、承認プロセス、判断根拠の重要性はむしろ高まります。
GBSでは、CONTACT Softwareの導入だけでなく、BOMや設計変更管理の整理、既存CAD・ERP等との連携、AIエージェント活用を見据えた製品情報基盤の構築まで、企業の現在の業務・システムに合わせて支援しています。
2026年11月17日開催|製造業向けオンラインセミナー
AIエージェントで
設計変更管理はどう変わるか
PLMを中核に、設計変更の影響をAIが辿れる製品データ基盤を考える
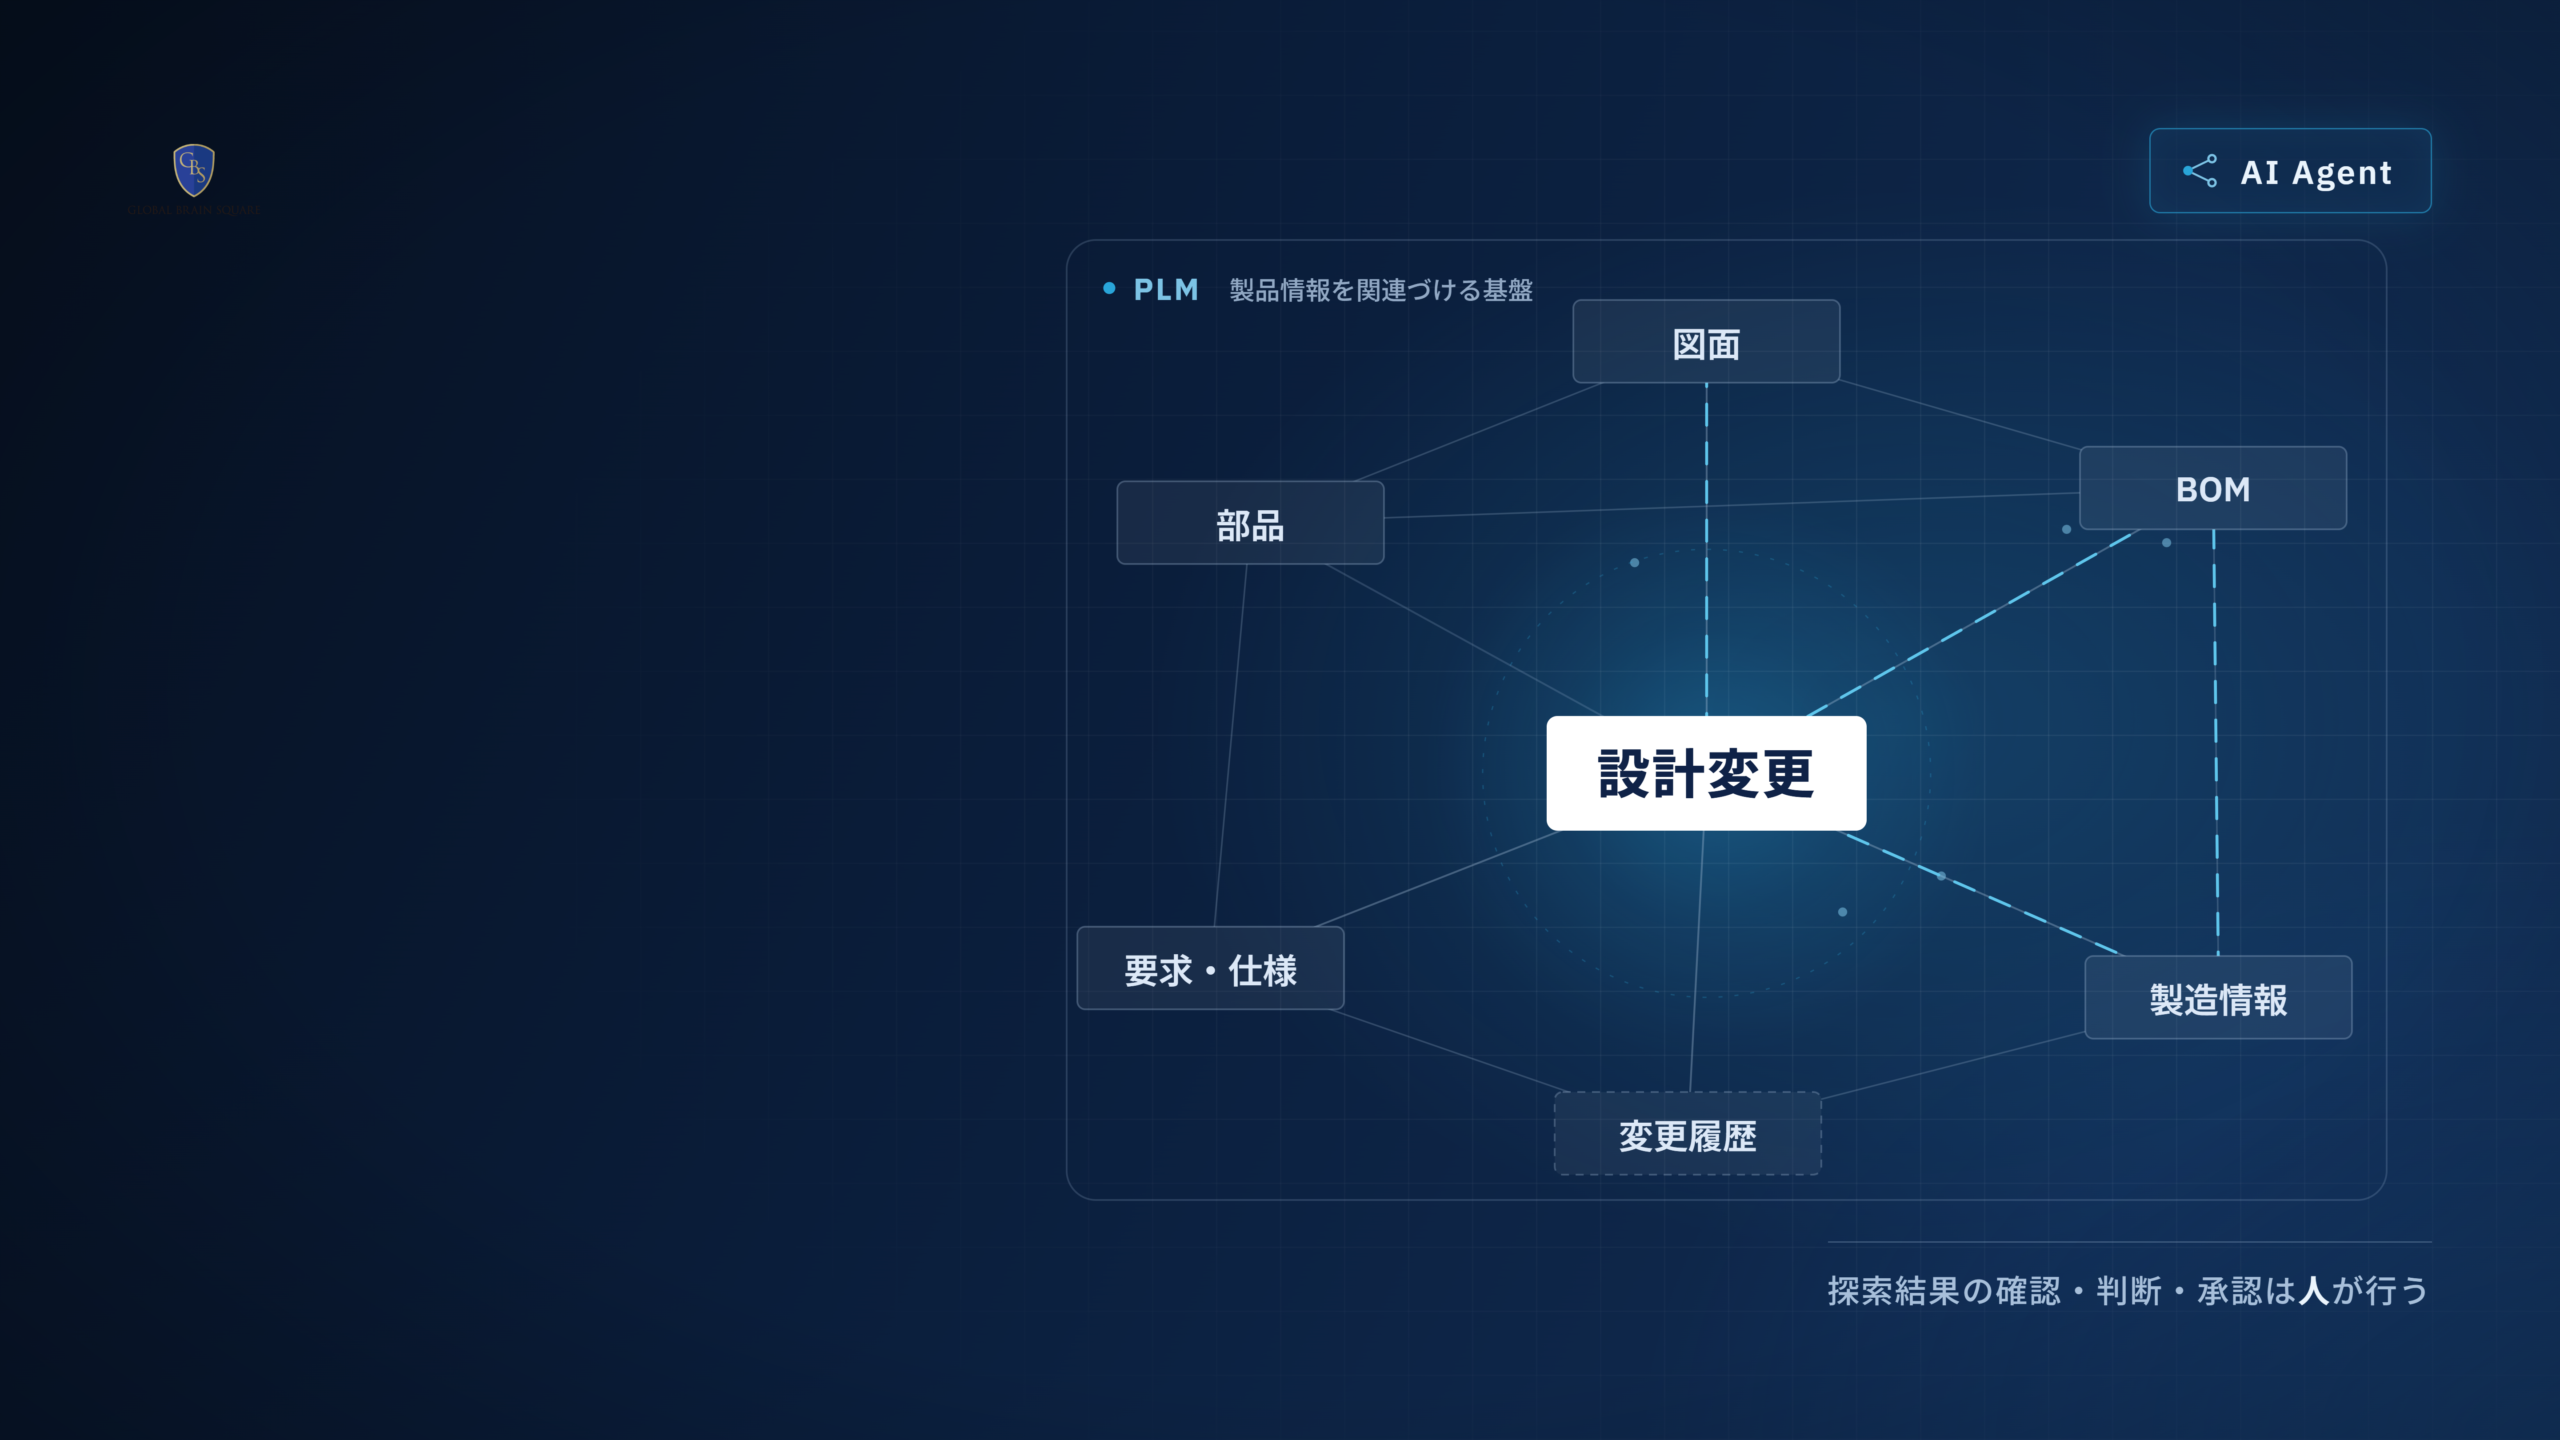
要求、部品、図面、BOM、製造情報――設計変更の影響は、ひとつの部門やシステムだけでは完結しません。AIエージェントは、その複雑な確認作業をどこまで支援できるのでしょうか。
2026年11月17日(火)
15:00~16:00
Zoomウェビナー
参加無料
設計変更の影響調査は、AIに任せられるのか
設計変更では、変更する図面や部品だけを確認すればよいわけではありません。変更の起点となった顧客要求、関連する部品やBOM、製造・調達への影響、承認状況、過去の変更履歴などを確認し、関係者が判断できる状態にする必要があります。
AIエージェントには、複数の情報を探し、関連情報を集め、影響の候補を示し、内容を要約するといった支援が期待されています。一方で、システムへ接続できることと、必要な情報を信頼して辿れることは同じではありません。
本セミナーでは、AI万能論にも「すべてを一つのシステムへ集約すべき」という単純論にも寄らず、設計変更管理の実務から、AIが働ける製品データ基盤とPLMの役割を考えます。
このような課題はありませんか?
PLMをすでに知っている方、導入・刷新やAI活用を具体的に考え始めている方にも向けた内容です。
変更の起点となった顧客要求まで遡れない
図面やBOMの変更は管理していても、どの要求や仕様変更が起点だったのかを追うには手間がかかる。
影響範囲の確認が担当者の経験に依存している
関連部品、類似案件、製造・調達への波及を、熟練者が複数の資料やシステムを見ながら判断している。
PDM・PLM・ERPなどに情報が分かれている
API連携や検索はできても、どの情報が正本か、同じ対象をどう識別するか、情報同士をどう対応づけるかが整理されていない。
E-BOMとM-BOMの変更をどうつなぐか悩んでいる
設計側の変更を製造側へ確実に伝え、異なるBOM間の影響を確認できる仕組みを検討している。
AI活用をPoCで終わらせたくない
検索や要約のデモだけでなく、実際の設計変更業務で安全かつ継続的に使える条件を知りたい。
PLMをAI時代にどう位置づけるべきか迷っている
既存PDMやERPを活かしながら、PLMをどこまで中核基盤として整備すべきか判断したい。
AIで変わること、変わらないこと
情報を探す時間は、もっと短くできる
AIエージェントは、要求、部品、図面、BOM、変更履歴、関連文書などを横断し、人が確認すべき情報を集める役割を担える可能性があります。
影響候補は示せても、その先には業務上の判断がある
AIが示した情報をどのように確認し、実際の設計変更判断へつなげればよいのでしょうか。本セミナーでは、その際に考えるべきポイントを整理します。
AIエージェントを業務で使うと、新たに見えてくる課題がある
複数のシステムへAIからアクセスできれば、それだけで設計変更の影響を正しく判断できるのでしょうか。実務でAIを活用する際に見えてくる課題を考えます。
PLMはAI時代にどのような役割を担うのか
AIエージェントの活用が広がる中、PLMや既存の業務システムをどのように位置づければよいのでしょうか。設計変更管理を題材に考えます。
本セミナーで分かること
答えを先に並べるのではなく、設計変更の実務を題材に判断のポイントを整理します。
01
設計変更で本当に追うべき情報
要求から設計、BOM、製造・調達まで、影響確認の論点を整理します。
02
AIエージェントが支援できる範囲
探索、収集、影響候補の提示、要約など、現実的な活用場面を考えます。
03
AIだけでは解けないデータの課題
AIを実務で使ううえで、データ側にどのような論点があるのかを整理します。
04
分散システムとPLMの役割分担
一元化か分散かという二択ではなく、AI活用を前提とした構成を考えます。
05
CONTACT Softwareで描ける実装像
製品情報と変更プロセスのつながりを、CONTACTの考え方を例に紹介します。
06
自社で次に確認すべきこと
AI活用やPLM整備を検討する際に、最初に確認したい論点を整理します。
セミナープログラム
15:00~15:05
オープニング
前回テーマとのつながりと、本日の問題提起
15:05~15:20
第1部:なぜ設計変更の影響調査は難しいのか
- 設計変更は、変更対象だけを見ても判断できない
- 顧客要求・部品・図面・BOM・製造情報のつながり
- 情報が分散している企業で起きる実務上の問題
15:20~15:38
第2部:AIエージェントで何が変わるのか
- 情報探索・関連情報収集・影響候補提示の可能性
- AIの回答を業務で信頼するための条件
- APIで接続できることと、情報を辿れることの違い
15:38~15:55
第3部:PLMとCONTACT Softwareで考える実装イメージ
- 製品情報の関係と変更プロセスをどう管理するか
- 要求・BOM・文書・変更・タスクをつなぐ考え方
- 既存PDM・ERPを活かしながらAI活用へ進む視点
15:55~16:00
質疑応答
事前質問および当日のQ&Aにお答えします。
AIエージェント×設計変更管理を、具体的な業務から考えたい方へ
製品紹介だけのセミナーではありません。設計変更という業務課題を起点に、AIで変わる部分と、AIを活かすために考えるべき製品データのあり方を実務目線で解説します。
Zoomウェビナーに無料で参加登録する
CONTACT Softwareを例に考えること
CONTACT Elementsの仕組みを例に、設計変更とAI活用を支えるデータのつながりを紹介します。
要求と製品情報の関係
要求から部品、文書、タスクなどへ、変更の起点と影響先を辿る考え方。
BOMと設計変更プロセス
ECR・ECO・ECN、承認、関連資料を、製品構成と切り離さずに扱う考え方。
既存システムとの連携
PDM、ERP、MESなどを含む環境で、システム間の情報をどうつなぐか。
AIを重ねるための前提
権限や履歴を保ちながら、AIエージェントが必要な情報へアクセスする構想。
当日は、CONTACTで扱える領域と、個別設計・検証が必要な領域を分けてご紹介します。AIによる設計変更判断の完全自動化をうたう内容ではありません。
こんな方におすすめです
製造業の設計・技術・生産技術・DX推進・情報システム部門などで、次のテーマを担当されている方を想定しています。
設計・技術部門の責任者
- 設計変更のリードタイムや確認漏れを改善したい方
- 属人的な影響調査を見直したい方
- 顧客要求と設計成果物をつなげたい方
PLM・PDM・BOMの担当者
- PLM導入・刷新を具体的に検討している方
- E-BOMとM-BOMの連携に課題を感じている方
- 既存PDMやERPとの役割分担を整理したい方
DX・情報システム部門
- 設計データを部門横断で活用したい方
- 複数システムの正本管理やID連携を検討している方
- AIが安全に社内データへアクセスする構成を考えたい方
AI活用・PoCの担当者
- 設計業務へのAI活用場面を探している方
- 検索・要約から一歩進んだ活用を検討している方
- PoC前にデータ基盤の論点を押さえたい方
登壇者プロフィール
岩本 謙一郎
株式会社グローバルブレインスクエア 代表取締役
約30年にわたり、製造業の業務改革、SCM(サプライチェーン・マネジメント)、PLM(製品ライフサイクル・マネジメント)、設計情報管理に関するコンサルティングに従事してきました。
現在は、受注設計型製造業を中心に、PLM導入、BOM・設計変更管理、製品情報基盤の構築を支援しています。
ドイツのPLMベンダーCONTACT Softwareのソリューションを活用した導入支援に加え、PLMや既存業務システムに蓄積された情報をAIエージェントから活用するための構想・実証にも取り組んでいます。
開催概要
- セミナー名
- AIエージェントで設計変更管理はどう変わるか
PLMを中核に、設計変更の影響をAIが辿れる製品データ基盤を考える
- 開催日
- 2026年11月17日(火)
- 時間
- 15:00~16:00(60分)
- 開催形式
- オンライン(Zoomウェビナー)
- 参加費
- 無料
- 主催
- 株式会社グローバルブレインスクエア
AIエージェントで設計変更管理はどう変わるのか。
設計変更の影響をAIが辿るために必要な製品データ基盤と、PLMの役割を具体的な業務から考えます。
無料で参加登録する
生成AIの業務利用が急速に広がる中、企業の情報システム部門や経営層に新たな課題が生まれています。
それが、BYOAI(Bring Your Own AI)とシャドーAI(Shadow AI)です。
従業員が個人で契約した生成AIを仕事でも利用する。会社が承認していないAIサービスに業務上の相談をする。自分用にカスタマイズしたAIを、そのまま職場でも使う。
こうした使い方は、すでに特別なものではありません。
MicrosoftとLinkedInが公表した2024 Work Trend Indexでは、仕事でAIを利用する人の78%が、自分で用意したAIツールを職場に持ち込んでいるとされています。日本でもBYOAIを行っているとの回答は78%で、世界平均と同じでした。Microsoftの発表を見る
しかし、ここには一つ大きな疑問があります。
個人所有のPCやスマートフォンを仕事に持ち込むBYODには慎重だった日本企業が、個人のAIを仕事へ持ち込むBYOAIを、そのまま認めてよいのでしょうか。
BYODには慎重だった日本企業
BYOAIを考える前に、BYOD(Bring Your Own Device)を振り返ってみましょう。
BYODとは、社員が個人で所有するPC、スマートフォン、タブレットなどを業務に利用することです。
日本企業では、BYODは必ずしも広く普及しませんでした。
IPAの「DX白書2023」によると、「個人保有のモバイルデバイスの業務活用」について、日本企業では「すでに導入」が11.3%、「導入予定」が13.9%であるのに対し、「導入予定なし」が50.1%でした。
一方、米国企業では「すでに導入」が29.8%、「導入予定」が30.1%で、日本企業よりBYODに積極的な傾向が確認できます。IPA「DX白書2023」を見る
日本企業がBYODに慎重だった理由は理解しやすいでしょう。
個人端末に会社の情報を保存すれば、紛失、盗難、マルウェア感染、退職後のデータ残存など、さまざまな情報管理上の問題が発生します。
そのため企業は、会社支給端末、端末管理、アクセス制御などを利用し、企業データを企業側で管理することを重視してきました。
ところが生成AIの時代には、BYOD以上に難しい問題が発生しています。
BYOAIとは?
BYOAIは「Bring Your Own AI」の略で、従業員が個人的に契約・利用しているAIサービスを業務にも持ち込んで利用することを指します。
たとえば、会社が契約している生成AIとは別に、個人契約の生成AIで資料を作成したり、業務上の相談をしたり、個人的に作成したカスタムAIやAIエージェントを仕事でも利用したりするケースです。
これに対してシャドーAIは、企業の情報システム部門や管理者が把握・承認していないAI利用を広く指します。
Google Cloudも、Shadow AIをBYODやShadow ITに続く企業IT上の問題として取り上げ、未承認の生成AI利用によるデータセキュリティ、プライバシー、コンプライアンス上のリスクを指摘しています。Google Cloudの記事を見る
つまり、BYOAIは「個人のAIを業務へ持ち込むこと」、シャドーAIは「企業から見えないAI利用が発生している状態」と考えると分かりやすいでしょう。
BYOAIが企業の管理外で行われれば、そのままシャドーAIになる可能性があります。
BYOAIはBYODより管理が難しい
BYODの場合、主な管理対象は「端末」と、その端末に保存されるデータでした。
端末を特定し、アクセス権を制御し、退職時には会社データへのアクセスを停止する、といった対応が可能です。
しかしBYOAIでは、個人が利用するAI環境の中に、業務に関するさまざまな情報が蓄積されていく可能性があります。
- 会話履歴
- アップロードしたファイル
- カスタム指示
- プロンプト
- AIエージェントの設定
しかも、問題は「ファイルが保存される」ことだけではありません。
AIに蓄積されるのは「仕事の文脈」
BYOAIのリスクとして最初に思い浮かぶのは情報漏えいでしょう。
顧客情報、設計情報、価格情報、契約書、ソースコード、経営資料などを、企業が管理していない生成AIへ入力することには慎重であるべきです。
ただし、「生成AIへ入力した情報は必ず学習され、他の利用者へ漏れる」と一括りにするのも正確ではありません。
データの保存期間、学習利用の有無、管理機能などは、AIサービス、契約プラン、設定によって異なります。
BYOAIでより本質的な問題になるのは、企業側が契約条件、データ保持、アクセス状況などを十分に管理・監査できないことです。
さらに、生成AIを継続的に使うと、単なるファイル以上のものがAIとの関係の中に形成されていきます。
たとえば営業担当者が個人AIへ、顧客への提案方法、過去の失注理由、価格についての考え方、競合企業への対応、上司が重視する判断基準、提案資料の作り方などを繰り返し相談していたとします。
そのAIは単なるファイル置き場ではありません。
その企業で仕事をするための文脈を持った、個人専用の仕事環境に近づいていきます。
BYOAIでは、企業秘密が「データ」として外部へ出るだけでなく、仕事の進め方や判断の背景、業務ノウハウまで企業の管理外に形成される可能性を考える必要があります。
個人が育てたAIは誰のものなのか
一方、ここでBYOAI特有の難しい問題が生じます。
生成AIを長期間利用している人の中には、自分の仕事のスタイルに合わせてAIをかなりカスタマイズしている人もいるでしょう。
たとえば、自分の文章表現、資料の構成方法、アイデア整理の方法、問題分析のフレームワーク、プログラミングのスタイル、よく使う指示方法などです。
こうしたものは、本人が時間をかけて培ったAI活用能力の一部とも考えられます。
実際、Microsoftの調査では、AI利用者は「時間を節約できる」「重要な仕事へ集中できる」「より創造的になれる」などの効果を挙げています。Microsoftの発表を見る
では、企業は社員に対して、「個人で育てたAIは業務では一切使用してはいけません。会社が用意した初期状態のAIだけを使ってください」と言えばよいのでしょうか。
これは簡単な問題ではありません。
個人が培ったAI活用方法と、会社の業務を通じて得たノウハウや情報の境界は、徐々に曖昧になっていく可能性があるからです。
個別の権利関係については契約や法制度、情報の内容によって異なるため、一律に「会社のもの」「個人のもの」と断定することはできません。
だからこそ、企業側であらかじめ方針を定めておく必要があります。
退職時にBYOAIの問題はさらに大きくなる
BYOAIで特に重要なのが、退職・転職時の問題です。
会社支給PCなら返却できます。
会社が発行したMicrosoft 365やGoogle Workspaceなどのアカウントであれば、退職時に停止できます。
しかし、社員本人が契約しているAIアカウントは企業側で管理できません。
もし個人AIの中に、業務上の会話履歴、会社資料、顧客情報、カスタム指示、業務で作成したAIエージェントなどが残っていれば、そのAI環境を退職後も本人が使い続ける可能性があります。
さらに、その社員が競合企業へ転職する可能性もあります。
従来の情報持ち出しでは、USBメモリへファイルをコピーするといった行為が問題になりました。
BYOAIでは、それとは異なり、会社で仕事をする中で形成された文脈やノウハウを持つAI環境そのものが、個人側に残る可能性があるという新しい問題が生じます。
退職時に削除を求めれば解決する、とも限りません。
企業に管理権限のない個人アカウントについて、企業側が完全な削除を確認・保証できるとは限らないからです。
そのため、退職時の対応だけでなく、在職中から企業情報を個人AIへ蓄積させない設計が重要になります。
シャドーAIはすでに企業リスクとして顕在化している
AIガバナンスの問題は、理論上の話だけではありません。
IBMの2025年「データ侵害のコストに関する調査」では、調査対象600組織の63%が、AIを管理したりシャドーAIの利用を防止したりするためのAIガバナンスポリシーを整備していませんでした。
また、シャドーAIの利用レベルが高い組織では、そうでない組織と比べ、世界平均のデータ侵害コストが67万米ドル高かったと報告されています。IBMの記事を見る
もちろん、この金額をそのまま日本企業へ当てはめることはできません。
しかし、生成AIの利用速度にガバナンス整備が追いついていないこと自体が、企業の新たなリスクになっていることは無視できません。
グローバル企業では、日本だけのAI利用ルールでは足りない
海外拠点を持つ企業では、問題はさらに複雑になります。
日本本社では法人契約AIのみを利用している一方、海外子会社では個人AIが自由に利用されている、といった状態になれば、企業グループとして統一した情報管理ができません。
個人情報、データの国外移転、プライバシー、AI関連規制などは国・地域によって異なります。
そのため、グローバル企業では、企業グループ共通のAI利用原則を設け、その上で各国・地域の法制度や事業環境に応じた追加ルールを設計するという考え方が必要になります。
「日本本社の生成AI利用ガイドライン」を作るだけでは十分ではない可能性があります。
情報システムガイドラインは「生成AIの項目を足す」だけでよいのか
これまで企業の情報セキュリティや情報システムに関する規程では、PC、スマートフォン、USBメモリ、メール、クラウドストレージ、パスワード、BYODなどが管理対象でした。
生成AI時代には、新たに多くの論点が加わります。
- プロンプト
- AIとの会話履歴
- アップロードファイル
- 個人AIアカウント
- AIの長期記憶
- カスタムAI
- AIエージェント
- AIから社内システムへのアクセス
- AIによる外部操作
さらに、社員の異動・退職や、海外拠点でのAI利用まで考えなければなりません。
したがって企業によっては、既存規程へ「生成AI利用上の注意事項」を数ページ追加するだけではなく、情報セキュリティ、アカウント管理、データ管理、外部サービス利用、開発、退職者管理などの関連規程全体を、AI利用を前提に再検討する必要が生じる可能性があります。
GBSでは、BYOAIの業務利用は原則慎重に考えるべきだと考えます
ここまでの論点を踏まえ、GBSでは、企業情報を扱う業務で個人管理のAIをそのまま利用するBYOAIについては、原則として慎重な立場を取るべきだと考えます。
特に、会社が管理できない個人AIへ企業情報や業務上の文脈が蓄積され、退職後もその環境が残る可能性を考えれば、企業情報を扱うAIは会社が管理することが基本になるでしょう。
これは生成AIそのものを禁止するという意味ではありません。
むしろ企業としてAIを積極活用するからこそ、会社の情報を扱うAIは、会社が管理できる環境で利用するという原則が重要になります。
一方で、それだけでは新たな問題が残ります。
では、個人が育ててきたAIの価値はどうするのか
BYOAIを原則禁止した場合、それまで社員が個人AIを使い込むことで培ってきたものはどうすればよいのでしょうか。
- 自分に合った文章表現
- 思考を整理する方法
- よく使うプロンプト
- 資料作成の進め方
- AIへの指示方法
こうしたものまで一律に捨てさせれば、AIを使いこなしてきた社員ほど、会社のAI環境に移ったときに生産性が低下する可能性があります。
BYOAIを制限することと、個人が培ったAI活用能力まで失わせることは、同じではありません。
では、個人が培ったAI活用能力を活かしながら、会社の情報や業務ノウハウは企業側で管理するには、どのような仕組みが必要なのでしょうか。
ここから先は、単なる「生成AI利用禁止事項」の作成では解決できません。
個人AIと会社管理AIの境界、パーソナライズ情報の扱い、企業データとの接続方法、アクセス権限、利用履歴、AIエージェントの実行権限、異動・退職時の管理、海外拠点を含む運用ルールなどを、企業ごとの業務実態に合わせて設計する必要があります。
まとめ―BYOAIは「使うか、使わないか」だけの問題ではない
BYOAIは、単純に「BYODのAI版」と考えるべきではありません。
BYODで企業が管理しようとしていたのは、主として端末と保存データでした。
BYOAIでは、それに加えて、AIとの対話、仕事の進め方、判断の背景、業務ノウハウ、個人向けに形成されたAI環境そのものが問題になります。
日本企業は、かつてBYODに慎重でした。
BYOD以上に企業と個人の境界が曖昧になる可能性があるBYOAIについても、利便性だけを理由に安易に解禁すべきではありません。
一方、個人AIを禁止するだけで、社員が培ってきたAI活用能力まで失わせる必要もありません。
これから企業が考えるべきなのは、「個人AIを会社へ持ち込む方法」ではなく、「個人が培ったAI活用能力を、企業情報を守りながら会社のAI環境で活かす方法」ではないでしょうか。
そのためには、AI利用規程だけではなく、企業の情報管理、AI環境、権限、データ、組織、人材を含めた新しいAIガバナンス設計が必要になります。
BYOAI・シャドーAIに関するよくある質問
BYOAIとは何ですか?
BYOAI(Bring Your Own AI)とは、従業員が個人で契約・設定した生成AI、カスタムAI、AIエージェントなどを業務でも利用することです。個人向けに蓄積したプロンプトや文章表現、仕事の進め方を活かせる一方、企業情報や業務上の文脈が会社の管理外にあるAIアカウントへ蓄積される可能性があります。そのため、個人AIと会社管理AIの利用範囲や、業務データを扱う際のルールを整理する必要があります。
BYOAIとシャドーAIは何が違いますか?
BYOAIは、従業員が個人で利用しているAIを業務へ持ち込むことを指します。一方、シャドーAIは、企業の情報システム部門や管理者が把握・承認していないAI利用全般を指します。BYOAIが企業の承認と管理のもとで行われる場合も考えられますが、会社が把握できない状態で利用されれば、シャドーAIになる可能性があります。
シャドーAIにはどのようなリスクがありますか?
主なリスクは、顧客情報、設計情報、契約書、ソースコード、経営情報などが、企業の管理していないAIサービスへ入力されることです。サービスごとにデータの保存場所や利用条件が異なるほか、企業側で利用履歴や削除状況を確認できない場合があります。
さらに、個人のAIアカウントへ仕事の進め方、判断基準、過去の相談内容などが蓄積されると、異動・退職時に業務ノウハウを企業側で回収・管理できない可能性があります。情報漏えいだけでなく、アカウント管理、アクセス権限、法令・社内規程への適合、利用履歴、退職者対応を含めて考える必要があります。
シャドーAIは生成AIの利用を禁止すれば防げますか?
利用禁止のルールを設けるだけで、すべてのシャドーAIを防げるとは限りません。業務に役立つAI環境が会社から提供されていなければ、従業員が個人AIを利用する動機が残る可能性があります。
禁止事項を示すだけでなく、会社が管理するAI環境を用意し、扱える情報の区分、個人アカウントとの境界、アクセス権限、利用ログ、人による承認、異動・退職時の取り扱いなどを具体的に設計することが重要です。また、従業員が個人AIの利用を通じて培ったプロンプト作成や業務改善の能力を、企業情報を持ち込まずに会社管理AIで活かせる方法も検討する必要があります。
BYOAI/シャドーAIへの対応を、自社ではどこまで進めるべきでしょうか?
GBSでは、企業ごとの業務内容、情報区分、既存システム、海外拠点などを踏まえ、BYOAI/シャドーAI対策、AI利用ポリシー、会社管理AI環境、AIハーネスを含むAIガバナンスの設計をご支援します。
「全面禁止すべきか」「どこまで利用を認めるべきか」「社員が培ったAI活用能力をどう活かすか」など、企業によって適切な設計は異なります。
自社に適したAI利用環境について、まずはGBSへご相談ください。
BYOAI/シャドーAI対策について相談する
AIエージェント導入・AIガバナンス支援について詳しく見る
参考情報
2026年9月11日開催|オンラインセミナー
AIエージェント時代の設計DX
PDMからPLMへ ― BOM・設計変更情報をどうつなぐか
受注設計型製造業が直面する設計情報の分散問題。その解決が、AIエージェントを設計業務で活用していくための第一歩です。
本セミナーは終了しました
2026年9月11日にオンラインで開催し、多くの皆さまにご参加いただきました。お申し込みいただいた皆さま、ありがとうございました。
本ページでは、セミナーで取り上げたテーマやプログラムを開催記録としてご紹介しています。
受注設計型製造業の設計DX課題
産業機械、生産設備、FA自動化設備、工作機械など、案件ごとに仕様・構成が変わる受注設計型製造業では、設計情報の管理がますます複雑になっています。
多くの企業では、CADシステム、PDM、ERP、図面検索システム、ワークフローなど複数のシステムが導入されています。しかし、それぞれが個別に機能しているだけでは、設計情報を部門や業務の壁を越えて活用することは容易ではありません。
同時に、生成AIやAIエージェントを設計業務へ活用したいという期待も高まっています。しかし、AIエージェントが設計業務を横断的に支援するためには、図面、部品、BOM、仕様、変更履歴などの情報が関連づけられ、必要な情報を参照できる設計情報基盤が重要になります。
本セミナーでは、受注設計型製造業が直面する設計情報管理の複雑さを整理し、PDMで培ってきた設計情報資産をどのようにBOM・設計変更管理・PLMへ広げていくか、そしてそれがなぜAI活用の基盤となるのかを、具体的かつ実務的に解説しました。
このような課題はありませんか?
受注設計型製造業の設計・技術部門で起こりやすい課題です。
PDMを導入しているが、BOMや設計変更管理まで一体化できていない
図面や部品情報は管理できているものの、各案件の構成情報や変更による影響の把握が複数のシステムに分散している。
図面は管理できているが、部品・案件・仕様書との関係を追いにくい
図面を管理できていても、その背景にある設計意図や案件の文脈、外部仕様書などとの関連付けが十分ではない。
CAD、PDM、ERP、図面検索、ワークフローが個別に分かれている
各システムは必要に応じて導入されているものの、システム間のデータ連携が十分ではなく、情報の二重入力や不整合が発生している。
設計変更の影響範囲を複数のシステムで確認している
部品変更の波及範囲を把握するために複数のシステムを行き来し、手作業で影響を追っている。
過去案件の設計情報を再利用しにくい
類似案件や過去の設計が存在していても、必要な情報を効率的に検索し、次の案件へ活用する仕組みが十分ではない。
設計ノウハウが担当者や個別システムに分散している
ベテラン設計者が持つ知見や過去の失敗事例が、個人のファイルや経験の中に留まっている。
AIを活用したいが、AIに参照させる設計情報が整理されていない
AI導入への関心はあるものの、どの情報をどのような形でAIへ提供すればよいのか整理できていない。
AIエージェントから図面・BOM・技術文書を横断的に活用したい
AI時代を見据え、複数の情報源を横断的に参照・活用できる情報基盤の必要性を感じている。
これらの課題の背景には、「システムが不足している」ということだけではなく、既存の設計情報が十分に関連づけられず、分散した状態で存在しているという問題があります。本セミナーでは、この構造的な課題にどう向き合うかを掘り下げます。
なぜ今「AIエージェント時代の設計DX」なのか
設計情報管理の複雑さと、AI活用への期待が同時に高まっている
受注設計型製造業では、これまでCAD、PDM、ERP、図面検索、ワークフローなど、目的に応じてさまざまなシステムが導入されてきました。その結果、個々の業務は効率化されても、設計情報全体を横断して活用するという点では課題が残るケースがあります。同時に、生成AIやAIエージェント技術の進展により、設計業務でのAI活用への期待も高まっています。
AIエージェントが活躍するには「つながった情報」が重要
AIエージェントを設計業務に活用する場合、単一のシステムやデータソースだけでは十分でないケースがあります。「この部品は過去どの案件で使われたか」「この設計変更はどこまで影響するか」といった問いに答えるには、図面、BOM、部品、案件情報、設計変更履歴などが関連づけられ、必要に応じて横断的に参照できることが重要です。
「検索・気付き」から「業務支援」へ
AI活用は、必要な情報を検索・要約する段階から、複数の情報を確認しながら次の業務を支援する段階へ広がりつつあります。そのためには、AIそのものを導入するだけでなく、AIが判断材料として利用できる設計情報の関係性を整えておくことが重要になります。
PDMで築いた資産をPLMへ段階的に広げる
すでにPDMで図面や部品情報を管理している場合、その資産を活かしながらBOM、設計変更管理、製造・調達情報との連携へ段階的に広げていくことができます。本セミナーでは、大規模な刷新を前提とせず、既存資産を活かしながらPLMとAI活用へつなげていく考え方を紹介しました。
本セミナーで分かること
60分のセミナーを通じて、以下のポイントを解説しました。
01
受注設計型で設計情報が複雑化する理由
なぜ案件ごとに仕様が変わる製造業では、設計情報管理が難しくなるのか。その構造的な理由を整理しました。
02
PDM・PLM・ERP・図面検索の役割の違い
各システムが何を管理し、どのような役割を担うのか、相互の関係を整理しました。
03
PDMからBOM・設計変更管理・PLMへ広げる考え方
既存のPDM資産を活かしながら、管理対象を段階的に広げていく考え方をご紹介しました。
04
図面、部品、BOM、文書、変更履歴を関連づける仕組み
分散した情報を相互に関連づけ、必要なときに参照できる状態へ近づけるための考え方を整理しました。
05
AIエージェントを活用するために必要な設計情報基盤
設計情報基盤とAIエージェントをどのようにつなぎ、どのような業務活用が考えられるのかをご紹介しました。
06
全面導入ではなく、小さく始める方法
大規模なシステム刷新を前提とせず、現状の環境を活かしながらPoCや段階導入につなげる考え方をご紹介しました。
セミナープログラム
15:00~15:05
オープニング
ご挨拶、株式会社グローバルブレインスクエア・登壇者紹介、本日のテーマと問題意識の共有
15:05~15:20
第1部:AIエージェント時代に求められる設計情報基盤
- なぜ今、設計DXとAIエージェントを一緒に考える必要があるのか
- 受注設計型製造業で設計情報が複雑になりやすい理由
- 図面、部品、BOM、仕様、案件、変更履歴が分散する問題
- AIエージェントを活用するために必要な「参照できる情報基盤」
- 単にAIツールを導入するだけでは不十分な理由
15:20~15:40
第2部:PDMからPLMへ ― BOM・設計変更情報をどうつなぐか
- PDMとPLMの違い、それぞれの役割
- PDMで管理してきたCAD・図面・部品情報をどう活かすか
- E-BOM(Engineering BOM)とM-BOM(Manufacturing BOM)の関係
- 設計変更情報を製造・調達などへどうつなぐか
- ERP、図面検索、ワークフローなど既存システムとの役割分担
- 設計部門だけで閉じず、製品ライフサイクル全体へ広げる考え方
15:40~15:55
第3部:PLMとAIエージェントで設計業務はどう変わるか
- PLM上で図面・BOM・文書・変更履歴がつながる意味
- 過去案件・類似部品・設計ナレッジの再活用
- AIエージェントによる横断検索の考え方と利用イメージ
- 「この部品は過去どの設備で使われたか」などの利用イメージ
- AI活用の前提として必要なデータ整備
- 全面導入ではなく、小さく始めるPoCと段階導入の進め方
15:55~16:00
質疑応答
事前質問への回答、当日のQ&Aを行いました。
セミナーの構成:第1部でAIエージェント時代の設計情報基盤について問題意識を共有し、第2部でPDMからPLMへの展開を具体的に解説します。そのうえで、第3部ではPLMとAIエージェントをどのように接続していくかをご紹介しました。
セミナー内容に関連する情報
セミナーで取り上げたPLM、E-BOMとM-BOM、AIエージェントと製品情報基盤について、以下のページで詳しく解説しています。
現在の業務や製品情報、PDM・ERPなどの既存システムとの関係を整理し、BOM管理、設計変更管理、製品選定、段階導入、運用定着まで支援します。
設計部門で扱うE-BOMと、製造部門で扱うM-BOMの役割の違い、設計変更を含めた連携の考え方を解説しています。
AIエージェントが図面、BOM、仕様書、変更履歴などを横断的に活用するために、どのような製品情報基盤が必要になるのかを解説しています。
こんな方におすすめです
受注設計型製造業の設計・技術・DX推進・情報システム部門などで、次のようなテーマを担当されている方を想定しています。
経営層・部門責任者
- 設計部長、技術部長
- DX推進部門の責任者
- 設計DX全体の戦略を検討している方
設計・技術部門の実務担当者
- 設計DX担当者
- BOM、設計変更管理担当者
- 設計情報管理に関わる担当者
システム企画・導入推進担当者
- PDM/PLMの導入・刷新を検討している方
- 情報システム部門の企画・導入担当者
- 既存システムの統合・連携を検討している方
AI活用を検討している方
- AI活用を検討しているが、設計情報基盤に課題を感じている方
- AIエージェント導入を見据えた準備を進めたい方
- 設計情報の整備がAI活用にどうつながるかを知りたい方
登壇者プロフィール
岩本 謙一郎
株式会社グローバルブレインスクエア 代表取締役
約30年にわたり、製造業の業務改革、SCM(サプライチェーン・マネジメント)、PLM(製品ライフサイクル・マネジメント)、設計情報管理に関するコンサルティングに従事してきました。
現在は、受注設計型製造業を中心に、PLM導入、BOM・設計変更管理、製品情報基盤の構築を支援しています。
ドイツのPLMベンダーCONTACT Softwareのソリューションを活用した導入支援に加え、PLMや既存業務システムに蓄積された情報をAIエージェントから活用するための構想・実証にも取り組んでいます。
製造業の現場課題を踏まえながら、業務とシステムの両面から導入・活用を支援しています。
開催概要
- セミナー名
- AIエージェント時代の設計DX
PDMからPLMへ ― BOM・設計変更情報をどうつなぐか
- 開催日
- 2026年9月11日(金)
- 時間
- 15:00~16:00(60分)
- 開催形式
- オンライン(Zoomウェビナー)
- 参加費
- 無料
- 主催
- 株式会社グローバルブレインスクエア
PLM・設計情報基盤について個別にご相談いただけます
PDMで管理してきた図面・部品情報を、BOM、設計変更管理、製造・調達情報へどのように広げるかは、現在の業務やシステム構成によって異なります。
PLM製品が決まっていない段階や、現在のPDM・ERP・Excelを活かした進め方を検討している段階でもご相談いただけます。AIエージェント活用を見据えた製品情報基盤についても、現在の業務とデータを確認しながら検討します。
製造業において、サーキュラーエコノミー(循環型経済)への関心が高まっています。資源効率の改善、廃棄物の削減、製品寿命の延長、リユース・リマニュファクチャリング、使用実績に基づくサービスモデルなど、従来の「作って、売って、捨てる」モデルから、資源を循環させるモデルへの転換が求められています。
IoTデータ、デジタルツイン、AIエージェントを組み合わせることで、その循環を実務として動かせるのではないか。そうした期待も広がっています。
ただし、「IoTセンサーとAIを導入すれば、サーキュラーエコノミーを実現できる」という単純な話ではありません。循環型業務では、AIエージェントが何を参照し、どの製品・設備データを根拠にし、製品ライフサイクルの文脈をどこまで理解できるかが重要になります。
GBSは、AIエージェント時代のサーキュラーエコノミーを、単なる環境対策ではなく、AIエージェントが循環型業務を支援するための製品・設備情報基盤づくりとして捉えることが重要だと考えています。
製品情報、BOM、設計変更、設備データ、保全履歴、稼働実績などが整理され、信頼できる情報として管理されていなければ、AIは現場の判断に使える回答を返せません。反対に、製品・設備情報基盤が整っていれば、AIエージェントは予知保全、部品の再利用判断、設計改善へのフィードバック、使用実績に基づくサービス運用などを支援できるようになります。
この記事のポイント
- AIだけでサーキュラーエコノミーを実現することはできません。
- PLMの製品情報と、IoT・デジタルツインの設備情報をつなぐ必要があります。
- AIの導入前に、正本、関係性、履歴、権限を整理することが重要です。
- 小さな対象業務から検証し、段階的に適用範囲を広げる進め方が現実的です。
自社の製品・設備情報基盤について相談する
前回の「AIエージェント時代のPLM」では、AIエージェントが製造業の実務で活躍するためには、まず製品情報基盤が整っていなければならないという視点を紹介しました。
本記事では、その視点を製品ライフサイクル全体へ広げます。PLMが製品・設計情報の基盤であり、IoTやデジタルツインが設備・稼働情報の基盤であるならば、サーキュラーエコノミーは、両者をつなぐ情報基盤の上で実務化されます。
AIだけではサーキュラーエコノミーを実現できない
AIの性能が高くても、参照する製品・設備情報が整理されていなければ、現場で使える回答にはなりません。
サーキュラーエコノミーの実務では、たとえば次のような問いが発生します。
- この部品はどの製品に使われており、廃止後はどの代替品に置き換えられるのか。
- この設備にはどの程度の残存寿命があり、いつ保全を実施すべきか。
- 修理に必要な部品は在庫にあるか。回収品や類似設備から再利用できる部品はあるか。
- この製品の素材構成は、対象となるリサイクル要件を満たしているか。
- 設備の稼働データや不具合情報を、次期製品の設計改善にどう反映するか。
こうした問いに答えるには、AIよりも先に、製品情報と設備情報の構造、関係性、履歴が整理されていなければなりません。BOM、図面、設計変更、IoTセンサーデータ、保全履歴、稼働実績、不具合報告などが分断されている状態では、AIが参照できるのは個別の断片に限られます。
生成AIも同様です。文章生成や検索、要約に優れていても、単独で導入しただけでは循環型業務は前進しません。PLM、IoTプラットフォーム、デジタルツイン、保全管理、ERPなどと接続し、業務に必要な文脈と根拠を与える必要があります。
AIエージェントを検討する際には、「どのAIを使うか」だけでなく、AIが使うべき製品・設備情報が整理されているかを確認することが重要です。
AIエージェントを支える製品・設備情報基盤
AIエージェント時代には、PLMとIoTプラットフォームを、それぞれ独立した管理システムとしてだけでなく、AIが循環型業務を安全かつ実務的に支援するための情報基盤として捉える必要があります。
重要なのは、単に大量のデータを集めることではありません。
- どの製品情報が正本なのか。
- 現在有効なBOMや図面はどれか。
- どの設備データが、どの製品や部品に対応しているか。
- どの設計変更が、どの稼働結果や不具合に関係しているか。
- 誰がどの情報を閲覧し、更新し、承認できるか。
- AIの回答や提案が、どの情報を根拠にしているか。
こうしたライフサイクルの文脈を管理できて初めて、AIは現場の判断に利用できる情報を提示できます。
PLMが担う情報
PLMは、BOM、図面、仕様、素材情報、設計変更、部品構成など、製品に関する正本情報を管理します。
IoT・デジタルツインが担う情報
IoTやデジタルツインは、センサーデータ、稼働時間、負荷状態、異常履歴、保全履歴など、製品や設備が実際にどのように使われたかを管理します。
両者を関連付けることが重要
製品情報と稼働実績がつながることで、AIは「どの部品が、どの条件で、どの程度使われ、どのように修理・再利用・改善できるか」を検討できるようになります。
AIエージェントが「答えるAI」から「循環型業務を前に進めるAI」へ変わるには、PLMとIoT・デジタルツインをつなぐ情報設計が必要です。
サーキュラーエコノミーで想定されるAIエージェント活用例
予知保全と設備寿命の延長
AIエージェントは、温度、振動、圧力、稼働時間などのIoTデータと保全履歴を参照し、劣化傾向や異常の兆候を整理できます。保全担当者に点検候補や確認すべき項目を提示することで、故障後の対応から、状態に応じた保全への移行を支援します。
ただし、設備データが継続的に蓄積され、保全履歴とひも付いていることが前提です。拠点や設備メーカーによってデータ形式が異なる場合は、AI活用の前に識別方法やデータ項目を整える必要があります。
部品の再利用とリマニュファクチャリング
回収した製品や部品について、使用期間、修理履歴、負荷状態、部品構成などを参照し、再利用可能性を検討する際の候補をAIが提示できます。代替部品や過去の類似事例を探す作業にも活用できます。
そのためには、BOMの粒度、品番、属性、版、代替関係が統一されていなければなりません。最終的な再利用可否は、品質基準や安全基準に基づいて人が承認する運用も必要です。
デジタルプロダクトパスポートへの対応支援
デジタルプロダクトパスポート(DPP)では、対象となる製品に応じて、素材、構成、修理、再利用、リサイクルなどに関する情報管理が求められます。
AIエージェントは、PLMやBOMに登録された情報の収集、必要項目の確認、不足情報の抽出などを支援できます。ただし、元データが文書や部門ごとに分散し、どれが正本か分からない状態では、規制対応の根拠として利用できる情報にはなりません。
なお、DPPの具体的な要求項目や適用時期は、製品分野ごとの法令や今後の委任法令などによって段階的に定められます。対象製品に応じて、欧州委員会などの公式情報を継続的に確認する必要があります。
使用実績に基づくサービスモデル
設備の稼働時間、利用頻度、負荷状態などを継続的に把握できれば、定額保守、従量課金、成果に応じたサービスなど、使用実績に基づくサービスモデルの設計・運用を支援できます。
契約や課金の根拠として使用する場合には、データの欠損、測定方法、履歴保存、変更管理などを明確にし、関係者が同じ情報を確認できる状態にすることが重要です。
設備データから設計へのフィードバック
フィールドで発生した不具合、保全内容、交換部品、稼働条件を製品情報と関連付けることで、設計部門が次期設計で確認すべき課題をAIが抽出できます。
不具合情報だけを収集しても、対象となるBOM、図面、仕様、設計変更とつながっていなければ、具体的な改善対象を特定することは困難です。製品情報と設備情報を双方向につなぐことが必要です。
廃棄物と資源効率の改善
製造実績、品質データ、材料使用量、廃棄量、エネルギー使用量などを横断して参照することで、廃棄物が多く発生している工程や、改善を検討すべきポイントを抽出できます。
AIが提示するのは、あくまで分析結果や改善候補です。品質、コスト、納期、安全性なども含めて、人が総合的に判断できる業務設計が必要です。
まずは対象業務を絞った検証が有効です
すべての製品・設備情報を最初から統合する必要はありません。予知保全、部品再利用、設計改善など、優先度の高い業務を一つ選び、必要なデータとシステム連携を確認する進め方が現実的です。
対象業務の選び方や進め方を相談する
AIエージェント時代の基盤整備で確認したい7つのポイント
1.製品・設備情報の正本をどこに置くか
BOM、図面、仕様、設備台帳、IoTデータ、保全履歴について、どのシステムを正本とするかを決めます。正本が曖昧なままAIを接続すると、回答の根拠や更新状況を確認できません。
2.PLMとIoT・デジタルツインを分断しないか
PLMの製品情報とIoTの稼働情報を、製品番号、部品番号、設備番号、シリアル番号などによって関連付けます。両者の関係がなければ、使用実績を設計改善や部品再利用へつなげることは困難です。
3.設計変更を知識として蓄積できるか
変更内容だけでなく、「なぜ変更したか」「どこに影響したか」「どの不具合や稼働実績が根拠になったか」まで追える状態を目指します。AIが改善提案を支援するには、判断の背景が必要です。
4.ライフサイクル全体のトレーサビリティを確保できるか
素材、調達、製造、使用、修理、回収、再利用、リサイクルの各段階について、必要な情報を追跡できるか確認します。すべてを一度に整備するのではなく、対象製品や規制要件に応じて優先順位を付けます。
5.権限、承認、根拠を管理できるか
AIが閲覧できる情報の範囲、提案内容を承認する担当者、回答の根拠となった情報を記録できることが重要です。特に再利用、保全、品質、規制対応などに関する判断を、AIだけで完結させない設計が必要です。
6.関連システムと連携できるか
PLMやIoTプラットフォームだけでなく、ERP、保全管理、品質管理、文書管理、サステナビリティ管理などとの連携を検討します。APIなどを通じて、必要なデータを適切な権限で利用できる構成が求められます。
7.Fit to Standardに加えてFit to AIを考えているか
標準機能に業務を合わせることは、導入・運用負荷を抑えるうえで重要です。さらにAIエージェント時代には、標準化した情報が「AIから参照できる」「関係性をたどれる」「根拠を確認できる」「別の業務でも再利用できる」状態になっているかを確認する必要があります。
Fit to Standardから、Fit to AIへ。
将来のAI活用を見据えて製品・設備情報基盤を設計することが、循環型業務を継続的に改善するための土台になります。
CONTACT Softwareで製品情報と設備情報をつなぐ
CONTACT Elements for IoTは、製品開発情報とフィールドで取得した設備情報を、デジタルツインを通じて関連付けるためのIoTプラットフォームです。
BOM、部品情報、設計データなどの製品情報と、稼働状態、測定データ、異常履歴、保全履歴などを関連付けることで、製品が設計された後に、実際の現場でどのように使われたかを追跡しやすくなります。
こうした情報基盤は、予知保全だけを目的とするものではありません。フィールド情報の設計部門への還元、部品の再利用検討、サービス事業の運用、将来のAIエージェント活用など、製品ライフサイクル全体にまたがる業務の基盤として利用できます。
GBSがご支援できること
GBSは、サーキュラーエコノミーへの対応を、単なる環境対策や単独システムの導入としてではなく、製造業DXを支える製品・設備情報基盤づくりとしてご支援します。
AIエージェントを導入すること自体を目的とせず、AIが循環型業務で機能するための情報設計、業務設計、システム連携、運用設計までを含めて検討します。
- 現状整理・構想策定:対象業務、製品情報、設備情報、関連システム、運用上の課題を整理します。
- PLM導入・活用支援:BOM、設計変更、図面、文書、素材情報などの管理方法を設計します。
- IoT・デジタルツイン基盤構築支援:設備データの取得、蓄積、可視化、製品情報との関連付けを支援します。
- PLMとIoTの連携設計:製品・部品・設備・稼働実績の関係を整理し、ライフサイクル情報を追跡できる構成を検討します。
- API連携・業務自動化支援:PLM、IoT、ERP、保全管理、品質管理などをつなぎ、情報収集や確認作業の自動化を支援します。
- AIエージェントを見据えた情報設計:AIが参照するデータ、権限、根拠表示、承認フロー、運用ルールを設計します。
重要なのは、特定のAIツールを先に決めることではありません。まず、自社の製品情報、設備データ、BOM、設計変更、保全履歴などが、AIエージェントから利用できる状態になっているかを確認することです。
よくあるご質問
AIエージェントがあれば、サーキュラーエコノミーを実現できますか。
AIエージェントだけで実現できるものではありません。AIが循環型業務を支援するには、信頼できる製品・設備情報基盤が必要です。PLMの製品情報と、IoT・デジタルツインの設備情報が整理され、関連付けられて初めて、予知保全、部品再利用、設計改善などの支援に利用できます。
IoTセンサーを設置すれば、予知保全を始められますか。
センサーの設置だけでは不十分です。取得するデータ、測定頻度、異常の判定方法、設備台帳や保全履歴との関連付け、通知後の業務フローまで設計する必要があります。まずは停止時の影響が大きい設備など、優先度の高い対象から段階的に検証する方法があります。
デジタルプロダクトパスポートへの対応は、いつから必要ですか。
DPPレジストリは2026年7月20日に運用が開始されています。ただし、企業に求められる具体的な情報項目や義務化時期は、製品分野ごとの法令や委任法令などにより段階的に定められます。自社製品が対象となる制度を確認したうえで、素材、部品構成、修理、再利用、リサイクルに関する情報を早めに整理することが重要です。
PLMとIoTプラットフォームは、別々に導入してもよいですか。
個別に導入することは可能です。ただし、将来的に製品情報と稼働情報を活用する場合は、製品番号、部品番号、設備番号、シリアル番号などによって両者を関連付けられるように設計しておくことが重要です。
AIエージェントと生成AIは同じものですか。
同じ意味で使われることもありますが、厳密には異なります。生成AIは文章生成や要約などのモデル機能を指すことが多く、AIエージェントは、生成AIに加えて検索、システム連携、ツール実行、業務フローの支援などを行う仕組みを指します。
まずAIツールを導入し、後から情報基盤を整備してもよいですか。
限定的なPoCであれば可能ですが、本番業務では課題が生じやすくなります。正本、更新状況、権限、情報の関係性が整理されていないと、回答の根拠を確認できず、判断業務に利用することが難しくなります。PoCと並行して、必要な情報基盤の整備方針を検討することをおすすめします。
サーキュラーエコノミー基盤の整備には、どの部門が関与すべきですか。
設計、製造、保全、品質、情報システム、DX推進、調達、環境・サステナビリティなどの横断的な関与が望まれます。対象業務によって必要な部門は異なるため、最初に目的と対象範囲を明確にすることが重要です。
どの業務からAI活用を始めるとよいですか。
業務上の課題が明確で、必要なデータを確保しやすく、効果を確認しやすい領域が適しています。たとえば、特定設備の保全支援、過去の不具合検索、交換部品候補の確認、設備情報からの設計課題抽出などです。全社展開を前提にせず、対象を絞って検証し、データと運用の課題を確認しながら広げていきます。
AIエージェント時代の製品・設備情報基盤をご検討中の方へ
サーキュラーエコノミーを実務として進めるには、AIそのものだけでなく、PLM、IoT、デジタルツイン、BOM、設計変更、保全履歴、関連システムを整理した製品・設備情報基盤が重要です。
GBSでは、現状業務とデータの整理、PLM・IoT基盤の構想、CONTACT Softwareの活用、システム連携、AIエージェントを見据えた情報・運用設計までご相談いただけます。
サーキュラーエコノミーとAI活用について相談する
参考情報
顧客情報基盤なき自律化は、なぜ空回りするのか
商談記録の自動作成、見込み顧客の優先順位付け、フォローアップメールの生成、問い合わせへの初期対応など、営業・マーケティング・カスタマーサービスにおけるAIエージェント活用が現実的になっています。
一方で、AIエージェントを導入しただけでは、期待した成果につながらないこともあります。その大きな要因の一つが、AIエージェントが参照する顧客情報の品質や構造です。
顧客情報が複数のシステムや個人管理のファイルに分散し、更新状況や正確性が不明なままでは、AIエージェントは適切な判断を行えません。AIエージェントが実力を発揮するためには、CRM/SFAを単なる営業活動の記録先ではなく、顧客接点全体を支える情報基盤として見直す必要があります。
本記事の位置づけ
本記事は、GBSが考える「AIエージェント時代の業務基盤」を取り上げるコラムです。今回はCRM/SFAをテーマに、顧客情報基盤の整備とAIエージェント活用の関係を解説します。

CRM/SFAが「使われない」「信頼されない」理由
AIエージェントの活用を考える前に、現在のCRM/SFA運用にどのような課題があるかを確認する必要があります。
多くの企業では、CRM/SFAを導入していても、入力される情報が不足していたり、更新が遅れていたりするため、営業活動の実態を正確に把握できない状態が生じています。
- 営業担当者が商談後の入力を後回しにしている
- 入力内容が担当者の記憶や主観に依存している
- 入力方法や情報の粒度が担当者ごとに異なる
- 営業、マーケティング、カスタマーサービスの情報が分断されている
- 顧客情報が表計算ファイル、メール、議事録、個人メモなどに散在している
- データは蓄積されているが、分析や次の行動に活用できていない
この状態では、CRM/SFAは顧客情報の正本として信頼されません。現場は別の資料を参照し、管理者もCRM/SFAの情報だけでは判断できないため、さらに利用が進まなくなります。
こうした構造を残したままAIエージェントを接続しても、AIが参照できるのは、不完全で古い顧客情報です。AIエージェントは情報を整理し、分析し、次の行動を提案できますが、元となる情報の不足や誤りを自動的に解消できるとは限りません。
CRMは「記録するシステム」から「実行を支える基盤」へ
従来のCRM/SFAは、顧客情報や営業活動を記録し、案件の進捗を管理するためのシステムとして利用されてきました。
AIエージェント時代には、この役割が変化します。CRM/SFAに蓄積された情報をAIが参照し、状況を判断し、担当者への提案や業務の実行まで行うようになるためです。
手動入力を前提としない運用
メール、カレンダー、Web会議、問い合わせフォームなどとCRM/SFAを連携することで、顧客との接点情報を自動的に取り込めるようになります。
例えば、Web会議の内容から商談メモを作成し、次回対応や顧客への約束事項を抽出してCRM/SFAに登録する仕組みが考えられます。担当者はゼロから入力するのではなく、AIが作成した記録を確認・修正する運用へ移行できます。
情報の提示から業務の実行へ
CRM/SFAに十分な情報が蓄積されていれば、AIエージェントは案件状況に応じた次の行動を提案できます。
さらに、事前に定めたルールや権限の範囲内で、フォローアップメールの下書き、タスクの登録、社内への確認依頼、顧客からの問い合わせの振り分けなどを実行することも可能になります。
画面の中だけで完結しないCRM
営業担当者がCRM/SFAの画面を開いて情報を探すのではなく、普段利用しているメール、チャット、社内ポータルなどから必要な顧客情報を呼び出す形も増えていくと考えられます。
CRM/SFAは一つの画面としてではなく、AIエージェントが安全に顧客情報を読み書きするための基盤としての重要性が高まります。
重要なのは「AI機能があるか」だけではありません
AIエージェントが適切に動くためには、顧客情報が整理され、必要なデータに接続でき、アクセス権や更新ルールが一貫して管理されていることが重要です。
AIエージェントが活用できる顧客情報基盤とは
AI機能を搭載したCRM/SFAを導入しても、蓄積されている顧客情報が断片的であれば、AIが行う判断や提案も不完全になります。
必要なのは、単にデータ件数を増やすことではありません。顧客情報の正確性、更新頻度、関連性、参照権限、情報の出所を含めて設計することです。
例えば、AIエージェントが顧客への次回提案を考える場合、商談履歴だけでなく、過去の問い合わせ、契約内容、利用中の製品やサービス、サポート状況、関連する社内文書なども判断材料になります。
これらの情報が別々のシステムに存在していても、必要な範囲で安全に参照できる仕組みがあれば、AIエージェントは顧客の状況をより立体的に捉えられます。
AIエージェントの具体的な活用場面
顧客情報基盤が整備されると、営業、マーケティング、カスタマーサービスにまたがる業務で、AIエージェントを活用しやすくなります。
営業活動における活用
営業準備と顧客リサーチ
顧客企業の基本情報、過去の接点、商談履歴、公開情報などを整理し、面談前に確認すべき内容を提示します。営業担当者が複数のシステムを横断して情報を探す負担の軽減が期待できます。
商談記録とフォローアップ
Web会議の内容を要約し、決定事項、顧客の課題、次回対応、提出を約束した資料などを抽出します。CRM/SFAへの記録やフォローアップメールの下書き、タスク登録までを連携できます。
案件管理と次の行動の提案
過去の商談履歴や案件状況を踏まえ、確認が必要な事項や停滞している案件を提示します。担当者が次に取るべき行動を判断するための支援として活用できます。
営業担当者の育成
商談記録や提案内容をもとに、説明不足の項目や確認すべき質問を提示します。ロールプレイングや面談後の振り返りを支援する用途も考えられます。
マーケティングにおける活用
- 顧客属性や過去の行動に基づく対象顧客の整理
- 顧客セグメントごとのコンテンツ案の作成
- 営業活動とマーケティング施策の接点分析
- キャンペーン結果の整理と改善案の提示
- 休眠顧客やフォローが必要な顧客の抽出
カスタマーサービスにおける活用
- 問い合わせ内容の分類と担当部門への振り分け
- 過去の対応履歴や契約情報を踏まえた回答案の作成
- 緊急度や重要度に応じた優先順位付け
- 定型的な手続きの案内や処理の自動化
- 人による判断が必要なケースのエスカレーション
すべてを最初から自動化する必要はありません。まずは情報収集、要約、入力補助、回答案の作成など、人が確認しやすい業務から始め、段階的に実行範囲を広げる方法が現実的です。
CRM/SFA基盤を見直す7つの視点
1.顧客情報の正本をどこに置くか
営業担当者のメモ、表計算ファイル、マーケティングツール、CRM/SFA、問い合わせ管理システムなどに顧客情報が分散している場合、AIエージェントはどの情報を正しいものとして扱うべきか判断できません。
すべての情報を一つのシステムへ物理的に集約する必要はありませんが、顧客に関する主要な情報をどこで管理し、どのシステムを正本とするかを明確にする必要があります。
2.部門間のデータ分断を解消できるか
営業、マーケティング、カスタマーサービスが別々の情報だけを参照していると、顧客の全体像を把握できません。
AIエージェントが顧客の状況を適切に判断するためには、担当者の権限に応じて、部門をまたぐ情報を関連付けて参照できる仕組みが必要です。
3.構造化データと非構造化データを関連付けられるか
案件金額、業種、商談フェーズなどの構造化データだけでなく、商談メモ、議事録、メール本文、問い合わせ内容などの非構造化データも重要な判断材料です。
これらを単なる文章の保管場所として残すのではなく、顧客、案件、製品、契約などの情報と関連付け、AIが検索・参照できる状態に整える必要があります。
4.情報の出所を追跡できるか
AIが自動生成した記録については、いつ、どの情報を根拠に、どの処理によって作成されたのかを確認できることが重要です。
人が入力した情報とAIが生成した情報を区別し、必要に応じて元となる会議記録やメールを確認できるようにすることで、業務上の判断に利用しやすくなります。
5.アクセス権をAIエージェントにも適用できるか
AIエージェントが利用者に代わって情報を参照・更新する場合も、利用者本人と同じアクセス権の範囲で動作する必要があります。
役職、担当顧客、所属部門、案件への関与状況などに応じた権限制御が、AIエージェントの処理にも一貫して反映される設計が求められます。
また、CRM/SFA側で権限を適切に管理していても、社員が個人契約の生成AIへ顧客情報や商談内容を入力していれば、企業側で利用状況や情報保持を十分に管理できない可能性があります。AIエージェント時代の顧客情報管理では、「誰がどの情報へアクセスできるか」だけでなく、「どのAI環境から利用できるか」まで含めて考える必要があります。
BYOAI・シャドーAIのリスクと企業が考えるべき対策を読む →
6.基幹システムや周辺システムと連携できるか
受注情報、請求情報、製品情報、契約情報、問い合わせ履歴などは、CRM/SFA以外のシステムで管理されていることがあります。
AIエージェントが業務全体を支援するためには、必要な情報をAPIなどで安全に連携し、複数のシステムをまたいで処理できる構成を検討する必要があります。
7.「使われないCRM」の原因を業務から見直せるか
AIによる自動入力は、営業担当者の負担軽減に役立ちます。しかし、入力項目が多すぎる、入力した情報が担当者自身の業務に還元されない、管理目的だけで運用されているといった問題は、AI機能だけでは解決できません。
入力ルール、会議体、案件管理方法、承認プロセス、評価方法などを含めて業務を見直し、CRM/SFAを使うことが担当者にも価値をもたらす設計に変える必要があります。
従来のCRM運用とAIエージェント時代の違い
| 観点 |
従来のCRM/SFA運用 |
AIエージェント時代のCRM基盤 |
| 主な役割 |
顧客情報や営業活動を記録する |
顧客情報を参照し、判断や業務実行を支援する |
| 情報入力 |
担当者による手動入力が中心 |
メール、会議、各種システムから自動取得し、人が確認する |
| 情報の範囲 |
案件情報や活動履歴が中心 |
営業、マーケティング、サポート、契約などを横断する |
| 非構造化情報 |
メモや添付ファイルとして保管する |
顧客や案件と関連付け、AIが検索・参照する |
| システム連携 |
必要に応じて個別連携する |
AIエージェントが横断利用できる接続基盤として設計する |
| ガバナンス |
利用者の入力権限や閲覧権限を管理する |
AIによる参照、生成、更新、実行まで含めて管理する |
| 導入後の運用 |
入力率や利用率を高める |
人とAIの役割、確認、承認、例外処理を継続的に改善する |
「Fit to AI」の視点でCRM/SFAを見直す
業務をパッケージの標準機能に合わせる「Fit to Standard」に加えて、これからはAIが情報を理解し、安全に業務を支援できる状態へ基盤を整える「Fit to AI」の視点が重要になります。
CRM/SFAには、データを入力する人と、そのデータを利用する人が一致しにくいという特徴があります。営業担当者が入力した情報を、管理者、マーケティング担当者、カスタマーサービス担当者などが利用するため、入力する側が直接的なメリットを感じにくいことがあります。
AIによる自動入力は、この問題を軽減する有効な手段です。しかし、自動化だけでCRM/SFAが顧客情報基盤として機能するわけではありません。
AIが作成した情報を誰が確認するのか、どの時点で正式な情報として扱うのか、誤りがあった場合にどのように修正するのか、重要な判断をどこから人へ引き継ぐのかといった運用設計が必要です。
CRM/SFAのFit to AIチェックリスト
| 観点 |
確認事項 |
| 入力の自動化 |
商談、メール、会議の記録を自動取得できるか |
| データ統合 |
営業、マーケティング、カスタマーサービスの情報を関連付けて参照できるか |
| 情報の構造化 |
議事録やメモを顧客・案件と関連付け、AIが検索できるか |
| トレーサビリティ |
AIが生成した情報の根拠や更新履歴を確認できるか |
| 権限制御 |
AIエージェントが利用者の権限範囲内で動作するか |
| 外部連携 |
基幹システムや周辺の業務基盤と安全に接続できるか |
| 運用設計 |
AIが生成・更新した情報の確認、承認、修正方法が定義されているか |
| 利用者への還元 |
入力・蓄積した情報が営業担当者自身の業務にも役立つか |
最初から大規模な再構築を行う必要はありません
顧客情報の棚卸し、商談記録の自動化、問い合わせ履歴との連携など、課題が明確な領域から始めることで、現行環境を活かしながら段階的にAIエージェント活用を進められます。
CRM/SFAとAIエージェント活用について相談する
GBSがご支援できること
GBSは、AIエージェント時代のCRM/SFAを単なる営業管理ツールではなく、顧客接点全体でAIエージェントが活躍するための顧客情報基盤として捉えています。
新しいツールを導入することだけを目的とせず、現在の業務、既存システム、蓄積されているデータを確認したうえで、必要な基盤整備と業務の見直しをご支援します。
顧客情報の棚卸しと基盤設計
顧客情報がどのシステムやファイルに存在し、どのように更新・利用されているかを整理します。情報の重複、欠損、更新ルール、正本の所在を確認し、AIエージェントが参照できる基盤の構成を検討します。
CRM/SFAの導入・再構築・移行支援
新規導入だけでなく、導入済みのCRM/SFAが十分に活用されていない場合の再設計にも対応します。業務要件の整理、データモデル、入力項目、権限、移行、定着化まで一貫して検討します。
業務プロセス設計と自動化
商談記録、フォローアップ、案件確認、問い合わせ対応など、具体的な業務を対象に、人とAIエージェントの役割を整理します。確認や承認が必要な処理を明確にし、段階的な自動化を支援します。
周辺システムとの連携
マーケティング、問い合わせ管理、基幹システム、文書管理基盤などとの連携を検討します。AIエージェントが業務に必要な情報を安全に参照できるよう、APIやデータ連携の構成を設計します。
AIエージェントを見据えたデータガバナンス
AIが参照できる情報の範囲、利用するAI環境、生成情報の扱い、更新履歴、承認方法、例外処理などを整理します。顧客情報を企業の管理外へ蓄積させないことも含め、AIエージェントを継続的に業務で利用するための運用ルールを設計します。
よくあるご質問
現在使っているCRM/SFAを変えずに、AIエージェントを活用できますか?
必ずしもCRM/SFAを変更する必要はありません。現在のシステムが持つAPIや外部連携機能を利用し、既存環境を活かしながらAIエージェントを接続できる場合があります。
ただし、顧客情報の重複や欠損が多い場合、情報が複数のシステムに分断されている場合、アクセス権が整理されていない場合は、先に基盤を見直した方がよいことがあります。まずは現在のデータと業務の状況を確認することが重要です。
AIを導入すれば「使われないCRM」の問題は解決しますか?
AIによる自動入力や要約は、営業担当者の入力負荷を軽減するうえで有効です。一方で、入力項目が業務に合っていない、情報が担当者自身に還元されない、管理目的だけで利用されているといった課題は、AI機能だけでは解決できません。
業務プロセス、入力ルール、会議や案件管理の方法、利用者への情報提供まで含めて見直す必要があります。
AIが自動入力した顧客情報は、どこまで信頼できますか?
AIによる自動記録は、手入力の負担や記録漏れを減らすことが期待されますが、会話の文脈や固有の業務ルールを誤って解釈する可能性があります。
重要な情報については担当者が確認する仕組みを設け、AIがどの情報を根拠に記録したのかを追跡できるようにすることが重要です。業務への影響に応じて、自動登録、確認後の登録、承認後の確定を使い分けます。
顧客情報が複数のシステムに分散していても取り組めますか?
取り組むことは可能です。すべてのデータを最初から一つのシステムへ移行するのではなく、どのシステムに何の情報があり、どの情報を正本とするかを整理するところから始めます。
優先度の高い情報から連携し、AIエージェントが必要な範囲で参照できる構成を段階的に整える方法があります。
小規模な営業チームでもAIエージェントを活用できますか?
小規模なチームでも取り組めます。担当者一人あたりの管理顧客数が多い場合や、顧客情報が個人のメールやファイルに蓄積されている場合は、情報整理や記録の自動化による効果を期待しやすいことがあります。
まずは商談記録の作成、顧客情報の検索、フォローアップ案の作成など、対象を限定して始める方法が現実的です。
どの業務からAIエージェント化すればよいかわかりません。
繰り返し発生している業務、情報を探す時間が長い業務、入力や転記が多い業務、対応漏れが起きやすい業務から整理します。
業務量だけでなく、利用するデータの状態、誤りが起きた場合の影響、人による確認の必要性も踏まえて優先順位を決めます。GBSでは、現状の業務と情報基盤を確認し、着手しやすいユースケースの整理からご支援します。
関連するGBSのサービス
CRM導入・活用支援
顧客情報の一元化や営業活動への活用に向けて、現在の業務とシステムを整理し、CRMの要件定義、設計、構築、運用定着までご支援します。特定の製品導入を前提とせず、顧客情報基盤をどのように整えるべきかという段階からご相談いただけます。
GBSのCRM導入・活用支援を見る
Vtiger CRM導入・AI活用支援
Vtiger CRMは、営業、マーケティング、カスタマーサポートの顧客情報を一つの基盤で管理するCRMです。GBSでは、業務整理、要件定義、設定、データ移行、既存システムとの連携、利用定着から、蓄積したCRMデータのAI活用まで一貫してご支援します。
Vtiger CRMの機能とGBSの導入支援を見る
AIエージェント導入・業務自動化支援
GBSは、汎用的なAIを導入するだけでなく、既存の業務、システム、データを活かして、企業固有の業務を支援するAIエージェントの設計・導入をご支援します。CRMに蓄積された顧客情報と、社内の業務基盤やナレッジを組み合わせた活用も検討できます。
GBSのAIソリューションを見る
製品情報と顧客情報をつなぐAI活用
製造業では、CRM/SFAに蓄積された顧客情報と、PLMに蓄積された製品・部品・変更情報を連携することで、提案、問い合わせ対応、保守などへのAI活用を検討できます。
CONTACT Softwareの概要を見る
社内の情報共有基盤との連携
顧客対応に必要な提案書、マニュアル、規程、過去事例などが情報共有基盤に蓄積されている場合、CRM/SFAの顧客情報と組み合わせたAIエージェント活用を検討できます。
情報共有・文書管理基盤の支援内容を見る
AIエージェント時代のCRM/SFA基盤整備をご検討中の方へ
「CRM/SFAを導入したが、十分に活用できていない」「営業データが複数の場所に散在している」「AIエージェントを試したいが、何から始めるべきかわからない」といった課題をお持ちではないでしょうか。
AIエージェント活用では、AI機能の選定だけでなく、現在の顧客情報、業務プロセス、システム連携、権限管理を整理することが重要です。
GBSでは、現状の顧客情報の棚卸しから、基盤構成、業務プロセスの見直し、AIエージェントの適用領域の整理まで、一貫してご支援します。
社内イントラネット・社内ポータルの領域において、AIエージェントへの期待が高まっています。社内向けWeb戦略の立案、情報設計、デザイン制作、コーディング、CMSとのAPI連携による配信自動化、問い合わせ対応や定期運用業務の自動化まで、社内コミュニケーションと内部情報基盤の現場でAIを活用したいという声は増えています。
ただし、ここで重要なのは、「AIツールを導入すれば社内ポータルが変わる」という単純な話ではないことです。
イントラネットの実務では、AIエージェントが何を参照し、どの社内文書を根拠に回答し、どこまで組織構造やアクセス権の文脈を理解できるかが成果を左右します。
GBSは、AIエージェント時代の社内ポータルやCMSを、単なる社内向けコンテンツの公開システムではなく、AIエージェントが社内業務で活躍するための内部情報基盤として捉えるべきだと考えています。
ページ、文書、コンポーネント、メタデータ、組織区分、アクセス権、版、承認などが整理され、信頼できる情報として管理されていなければ、AIは現場で使える成果を返せません。
反対に、内部情報基盤が整っていれば、AIエージェントは単なる社内チャットツールではなく、情報収集、問い合わせ対応、企画、設計、実装、運用業務の自動化まで、社内業務を前に進める存在になり得ます。

本記事の位置づけ
前回の「AIエージェント時代の大規模Webサイト・CMS基盤整備」では、大規模サイトにおけるコンテンツ情報基盤を取り上げました。本記事では、その考え方をイントラネット・社内ポータルという社内向けWebへ拡張します。
製品情報、対外コンテンツ、社内文書のいずれを扱う場合も、AIエージェントが価値を出す本質は、自然な文章を生成することだけではありません。業務に必要な情報へ適切にアクセスし、根拠と権限を保ったまま活用できることにあります。
AIエージェントが社内ポータルで注目される背景には、社内情報環境の複雑化があります。
従業員エンゲージメントの向上や意思決定の迅速化が求められる一方で、社内文書は情報共有基盤、チャットツール、各種SaaS、ファイルサーバーなどに分散しています。部門をまたぐ情報調整も増え、ベテラン社員が持つ知識の継承も課題になっています。
これまでのように、人が文書を探し、問い合わせに回答し、構成を考え、デザインやコードを作り、CMSへ入力して公開し、期限切れやリンク切れを点検するだけでは、対応スピードや業務の再現性に限界があります。
そこで期待されているのが、社内の情報源を横断的に検索し、利用者の所属や業務文脈に応じて情報を整理し、次のアクションにつながる形で支援するAIエージェントです。
特に社内ポータルでは、単なるチャット機能ではなく、コンテンツ、組織・アクセス権、問い合わせ履歴、承認ワークフロー、各種業務システムをつなぎながら、現場の判断と作業を支援することが求められます。
AIだけでは社内業務を改善できない理由
GBSは、AI単体では社内業務を改善できないと考えています。AIの性能が高くても、参照する社内情報やデータが整理されていなければ、現場で信頼して使える成果にはならないからです。
例えば、社内ポータルの運用では、次のような確認が日常的に発生します。
- この通達は現在も有効なのか、どの規程に基づいているのか
- この申請や承認フローには、どの部署・役職が関与するのか
- 同じ内容のお知らせが、過去に別の部署から発信されていないか
- このマニュアルの最新版はどれか、旧版との違いは何か
- この情報は全社員向けか、役職者限定か、特定部署限定か
- 問い合わせへの回答根拠として参照すべき文書はどれか
これらに回答するには、AIそのものよりも先に、社内コンテンツの構造、文書同士の関係、版、公開範囲、アクセス権が整理されていなければなりません。
ページ、文書、メタデータ、組織区分、版、承認、公開範囲が分断されたままでは、AIは断片的な情報しか扱えません。設計によっては、利用者に閲覧権限のない文書が回答生成に使われるなど、情報統制上のリスクにもつながります。
生成AIも同様です。生成AIは文章生成、要約、分類などに有力ですが、単体で導入するだけでは社内DXは十分に前進しません。
実務で活用するには、社内CMS、文書管理基盤、情報共有基盤、問い合わせ管理、人事・総務・情報システム部門の各システム、承認ワークフローなどと連携し、必要な文脈と根拠を持たせる必要があります。
つまり、AIエージェント導入の初期段階で問うべきなのは、「どのAI製品を使うか」だけではありません。
AIが利用すべき社内情報とデータが整理されているかを、先に確認する必要があります。
AIエージェントを支える社内ポータル・CMSという考え方
AIエージェント時代には、社内ポータルや社内CMSの役割も変わります。
これまで社内ポータルや社内CMSは、お知らせの配信、社内文書の掲載、申請への誘導、承認、公開といった仕組みとして語られることが一般的でした。これらは今後も重要です。
一方で、AIエージェントを社内業務で活用するには、社内ポータルやCMSを単なる公開システムとしてではなく、AIエージェントが安全かつ実務的に利用できる内部情報基盤として捉える必要があります。
社内ポータルが重要なのは、情報を一か所に集めることだけが理由ではありません。
どの文書が正本なのか、どの版が現在有効なのか、誰が参照できるのか、どの情報がどの組織・役職に公開されるのかといった業務文脈を持って管理できることに、本来の価値があります。
AIエージェントに必要なのは、単に大量の社内データを読み込ませることではありません。文脈が付与され、信頼性が確認され、アクセス権が適切に設定された社内データです。
この意味で、社内ポータルやCMSは「社内情報を掲載するシステム」から「AIエージェントが利用する内部情報基盤」へと、役割を広げつつあります。
- AIが正しい社内コンテンツや正本文書へアクセスできる
- ページ、文書、メタデータ、組織区分が関連付けられている
- 文書の版、改訂履歴、有効期間を追跡できる
- 部署、役職、機密区分などのアクセス権を保ったまま利用できる
- AIが生成した内容を人が確認し、承認できる
- 回答や提案が、どの情報を根拠にしたものか確認できる
こうした状態が整って初めて、AIエージェントは「質問に答えるAI」から「社内業務を前に進めるAI」へ変わります。
イントラネット・社内ポータル市場もAIエージェント前提へ
社内ポータルやエンタープライズ検索の領域では、AIを単独の付加機能としてではなく、構造化された社内コンテンツ、アクセス権、検索基盤、APIを前提に活用する動きが進んでいます。
例えば、Microsoftは、Microsoft 365 CopilotからSharePointページの作成を支援する仕組みを示しています。また、企業内検索においても、利用者の権限に応じて参照可能な文書を制御する考え方が重視されています。
社内ポータルや従業員体験プラットフォームの領域でも、社内問い合わせへの回答、情報検索、パーソナライズされた情報提供、業務タスクの実行などを、AIエージェントから支援する方向が広がっています。
重要なのは、「AI機能を搭載しているか」という機能比較だけではありません。
AIが参照できる情報をどのように整え、利用者の権限をどの段階で確認し、回答や処理の根拠をどのように残すかが、社内利用では特に重要になります。
AI搭載ポータルではなく、AIが活躍できる内部情報基盤へ
これからの検討では、チャット画面や生成機能だけを見るのではなく、その背後にあるコンテンツ管理、文書管理、検索、権限、承認、API連携まで含めて設計する必要があります。
社内ポータルにおけるAIエージェントの活用例
社内向けWeb戦略・利用状況分析
AIエージェントは、社内ポータルの利用状況を集計するだけでなく、課題を発見し、次の施策を提示するところまで支援する可能性があります。
部署別・ページ別の閲覧データや社内検索データを分析し、情報が届いていない部門、更新されていないトピック、問い合わせが集中している領域などを抽出する活用が考えられます。
さらに、分析結果を基に、お知らせの配信方法、ナビゲーション、コンテンツの統合、FAQの追加といった改善案を提示することも可能になります。
ただし、その前提として、ページ、対象者、部署、検索語、エンゲージメント指標などの計測設計が整っている必要があります。データの定義が曖昧なままでは、AIが数字を整理しても、具体的な改善判断には結び付きません。
情報設計・社内コンテンツの棚卸し
社内ポータルの情報設計は、AIエージェントを活用しやすい領域です。
既存コンテンツの棚卸し、サイトマップの再構成、部署・業務・対象者による分類の見直し、類似ページや重複文書の抽出、社内検索の導線改善などを支援できます。
一方で、社内コンテンツがページ単位やフォルダー単位でしか管理されておらず、対象部署、対象者、文書種別、版、有効期間などが定義されていない場合、AIは表面的な分類案しか出せません。
組織ごとの配信や、複数ページでの情報再利用まで見据える場合は、コンテンツモデルとメタデータの設計が必要です。
社内ポータルのデザイン制作
デザイン制作では、AIを活用して、ブランドガイドラインに沿った画面案、ページのバリエーション、画像編集、コンポーネント設計などを支援できます。
社内ポータルは、多数の部門が継続的にページを更新するため、デザインシステムや共通コンポーネントを整備する効果が大きい領域です。
ただし、カラー、タイポグラフィ、レイアウト、コンポーネント、文章のトーンなどが明文化されていなければ、AIが生成するデザインやコンテンツにもばらつきが生じます。
AI活用と併せて、社内ポータルのデザインルールを再利用可能な形で整える必要があります。
コーディング・コンポーネント実装
AIコーディングエージェントは、コンポーネントの実装、テストコードの作成、リファクタリング、障害調査などを支援できます。
社内ポータルでも、ページや機能がコンポーネント単位で整理され、デザインシステムとCMSの構造が対応していれば、実装や改修を効率化しやすくなります。
一方で、画面上の部品とCMS上のコンテンツ構造が一致していない場合、AIがコードを生成しても、CMSへの組み込みや入力設計で手戻りが発生します。
AIによる実装効率化を目指す場合も、コード、デザイン、CMSの各コンポーネントを対応させることが重要です。
社内CMS・情報共有基盤とのAPI連携
API連携は、AIエージェントを「回答するだけの仕組み」から「社内業務を実行する仕組み」へ広げるための鍵になります。
例えば、AIが社内コンテンツを検索して回答するだけでなく、更新案を作成し、承認申請を行い、人の確認を経て公開するといった流れが考えられます。
問い合わせ内容から必要な申請フォームを案内する、期限切れの文書を担当者へ通知する、更新が必要なページの一覧を作るといった処理も、各システムとのAPI連携によって実現しやすくなります。
ただし、CMSや文書管理基盤に十分なAPIがない場合、AIが情報を読むことはできても、安全に更新したり、承認フローへ接続したりすることが難しくなります。
問い合わせ対応と定期運用業務の自動化
問い合わせ対応と定期点検は、社内ポータルでAIエージェントの効果が期待される領域です。
人事、総務、情報システム部門などへの問い合わせの一次対応、申請手続きの案内、期限切れ文書の確認、リンク切れの点検、公開範囲の棚卸し、定例のお知らせ原稿の作成などを支援できます。
ただし、問い合わせ履歴、回答根拠、申請フロー、文書の有効期限、公開範囲などが構造化されていることが前提です。
根拠文書との関連付けがないままAIに回答を任せると、自然な回答は生成できても、内容が正しいかを確認できず、かえって二次対応が増える可能性があります。
AIエージェント時代の社内ポータル構築で考える7つのポイント
AIエージェントを前提にイントラネットや社内ポータルを構築する場合、現在必要な機能や製品の比較だけでは不十分です。
重要なのは、将来、AIが安全に利用できる内部情報基盤になっているかという視点です。
1. 社内情報の正本をどこに置くか
お知らせ、規程、マニュアル、申請書、議事録、画像などの正本管理が曖昧なままAIを導入しても、回答や提案の信頼性は上がりません。
まず、どのシステムや保管場所にある情報を正本とするのかを定義する必要があります。
複数の情報共有基盤、チャット、ファイルサーバー、業務システムに同じ文書が存在する場合は、AIがどの情報を優先すべきか判断できるように、正本とコピーの関係も整理します。
2. 構造化情報と非構造化情報を分断しないか
AIエージェントは、コンテンツモデルやデータベースのような構造化情報だけでなく、PDF、Word、画像、議事録、通達などの非構造化情報も横断して利用します。
社内では非構造化文書の割合が大きいため、両者を分断せず、文書種別、対象者、関連業務、版、有効期間などを通じて関連付けられる設計が重要です。
3. アクセス権と公開範囲をAIが守れるか
社内ポータルでAIを活用する場合、特に重要になるのがアクセス権です。
役員限定、特定部署限定、プロジェクト限定、個人情報を含む文書など、社内情報には複雑な公開範囲があります。
AIが回答を生成した後で表示を制限するのではなく、検索・取得する段階で、利用者が参照できる情報だけを対象とする設計が必要です。
AIエージェントが利用する検索基盤、文書管理基盤、APIのそれぞれで、利用者の所属や権限が正しく引き継がれるかを確認する必要があります。
4. 版管理・承認・トレーサビリティを保てるか
社内ポータルのAI活用では、利便性以上に統制が重要です。
AIがどの版の文書を根拠にしたのか、生成された更新案がどの情報に基づくのか、誰が確認・承認したのかを追跡できる必要があります。
AIが生成した内容を無条件に公開するのではなく、情報の重要度や公開範囲に応じて、人による確認と承認を組み込む設計が求められます。
5. 社内の各業務システムとつながるか
AIエージェントは、社内ポータルやCMSの中だけで完結するよりも、人事、総務、情報システム、申請・承認、文書管理、問い合わせ管理などのシステムとつながったときに、より大きな価値を発揮します。
社内ポータルを情報の入り口として、各業務システムを検索・参照・実行できるアーキテクチャを検討することが重要です。
6. API連携や将来のAI拡張が可能か
AIエージェント、エンタープライズ検索、RAG、デザインツール、コーディング支援などを組み合わせるには、API、webhook、検索インデックスなどの接続性が必要になります。
現在の運用課題だけで製品や構成を決めるのではなく、将来的にAIが情報を読み取り、処理を実行し、結果を書き戻せるかという観点で設計する必要があります。
7. Fit to Standardだけで終わらないか
標準機能に業務を合わせるFit to Standardは、引き続き重要です。
ただしAIエージェント時代には、標準化された業務や情報が、AIにとって「読める」「つながる」「権限を守れる」「再利用できる」状態になっているかまで確認する必要があります。
これからの社内ポータル構築では、Fit to Standardに加えて、Fit to AIという視点が求められます。
Fit to Standardから、Fit to AIへ
標準機能へ業務を合わせるだけでなく、標準化された情報や業務プロセスをAIエージェントが安全に利用できる状態へ整えることが、これからの社内情報基盤に求められます。
GBSがご支援できること
GBSは、イントラネットや社内ポータルの構築を、単なるシステム移行ではなく、社内DXとAI活用を支える内部情報基盤づくりとしてご支援します。
AIエージェントを導入すること自体を目的とせず、AIエージェントが社内業務で機能するためのコンテンツ設計、情報設計、アクセス権設計、API設計、運用設計までを一体として検討します。
社内ポータル・CMS基盤の構築、再構築、移行支援
- 既存コンテンツや社内文書の棚卸し
- サイト構造、ナビゲーション、検索導線の設計
- コンテンツモデルとメタデータの設計
- 版管理、承認、公開範囲、有効期間の設計
- 既存環境から新しい社内情報基盤への移行計画
アクセス権・ガバナンス設計支援
- 組織、部署、役職、プロジェクト、機密区分を踏まえた権限モデルの設計
- 検索・取得段階でアクセス権を反映する仕組みの検討
- AIが参照できる情報範囲と利用ルールの整理
- AI生成コンテンツの確認・承認ワークフロー設計
- 回答根拠や変更履歴を確認できる運用設計
API連携・業務自動化支援
- 社内CMSと文書管理基盤、情報共有基盤の連携
- 人事、総務、情報システム、問い合わせ管理などの業務システム連携
- API、webhook、検索基盤を活用した連携方式の設計
- 問い合わせ対応、承認、定期点検、更新通知の自動化
- 人の確認を含めた安全な自動化フローの設計
AIエージェントを見据えた社内情報設計
- 社内コンテンツの構造化と正本管理の整理
- 文書種別、対象者、組織、業務、有効期間などのメタデータ設計
- 社内検索性と情報再利用性の向上
- FAQと根拠文書の関連付け
- AI活用を見据えたデータ整備と業務プロセス設計
重要なのは、特定のAIツールを最初に決めることではありません。
まず、自社の社内コンテンツ、文書、アクセス権、版、承認、API、業務プロセスが、AIエージェントにとって利用可能な状態になっているかを確認することが重要です。
同時に、それらの情報をどのAI環境から、誰が、どの権限で利用できるようにするかも設計する必要があります。
GBSが考えるこれからの社内ポータルは、社内向けコンテンツを公開するためだけのものではありません。
AIエージェントが、情報収集、企画、設計、問い合わせ対応、申請案内、コンテンツ更新、定期運用など、複数の社内業務を支援するための基盤です。
Fit to Standardから、Fit to AIへ。
この視点で社内ポータルやCMSを見直すことが、AIエージェントを一時的な実証実験で終わらせず、社内業務へ定着させる第一歩になります。
一方で、社内情報基盤をAIエージェントから安全に利用できる状態へ整えるだけでは、AIガバナンスとして十分とは限りません。
社員が個人契約の生成AIを業務に持ち込んだり、会社が把握していないAIサービスへ社内情報を入力したりすれば、せっかくアクセス権や情報管理を整備しても、企業の管理外に業務情報や仕事の文脈が蓄積される可能性があります。
AIエージェント時代の社内情報基盤では、「どの情報をAIに使わせるか」だけでなく、「どのAI環境から利用させるか」まで含めて設計することが重要です。
FAQ
Q1. AIエージェントがあれば、社内ポータルやCMSは不要になりますか?
A. いいえ。むしろ、AIエージェントを実務で活用するほど、信頼できる社内情報基盤が重要になります。
社内ポータルやCMSは、AIが参照する情報の正本、版、関係性、対象者、アクセス権を管理する役割を担います。これらが整理されていなければ、AIが自然な回答を生成できても、その内容を社内業務で信頼して利用することは難しくなります。
Q2. 生成AIやAIアシスタントを導入すれば、社内ポータルはすぐに効率化できますか?
A. 単体導入だけでは、活用範囲が限定される可能性があります。
社内CMS、文書管理基盤、情報共有基盤、問い合わせ管理、各種業務システムと連携し、社内コンテンツの構造とアクセス権を整えることで、検索や要約だけでなく、問い合わせ対応や業務処理まで支援できるようになります。
Q3. なぜアクセス権設計がAI活用の鍵になるのですか?
A. 社内情報には、部署、役職、プロジェクト、機密区分などによって異なる公開範囲が設定されているためです。
AIが利用者に閲覧権限のない文書を参照すると、情報漏えいにつながる可能性があります。そのため、回答を表示する段階ではなく、検索・取得する段階で利用者の権限を反映する設計が必要です。
Q4. 社内文書やPDFが大量にあります。それでもAIを活用できますか?
A. 活用可能ですが、文書の整理が前提になります。
正本、版、有効期間、文書種別、対象者、公開範囲、関連業務などを整理し、検索や関連付けができる状態にする必要があります。文書が複数の場所へ分散したままでは、AIが情報を発見できても、どれが正しい情報か判断できない可能性があります。
Q5. AIエージェントと生成AIは同じものですか?
A. 厳密には異なります。
生成AIは、文章、画像、要約などを生成するモデルや機能を指すことが一般的です。AIエージェントは、生成AIに加えて、情報検索、ツールの実行、システム連携、判断、業務フローの遂行などを組み合わせた実行主体を指します。
Q6. 先にAIツールを導入し、後から社内ポータルを整備してもよいですか?
A. 小規模な検証であれば可能ですが、本番活用では限界が生じやすくなります。
情報基盤が未整備のままでは、回答根拠、更新への追従、アクセス権、版管理、トレーサビリティなどの課題が残ります。本格導入を見据える場合は、AIの検証と並行して、社内情報の正本やアクセス権を整理することが重要です。
Q7. AIエージェント時代の社内ポータル構築には、どの部門が関与すべきですか?
A. 社内広報や情報システム部門だけでなく、人事、総務、法務、セキュリティ、各業務部門などを含む横断的な体制が望まれます。
AI活用は、単なるシステム導入ではなく、社内情報の管理方法、業務プロセス、権限、責任範囲を見直すテーマだからです。
Q8. 対外WebサイトのCMS基盤と、社内ポータルの基盤は何が違いますか?
A. コンテンツを構造化し、版や承認を管理する基本的な考え方には共通点があります。
一方、社内ポータルでは、部署や役職によるアクセス権、機密区分、個人情報、問い合わせ、申請・承認など、社内業務との連携がより重要になります。対外Webのコンテンツ基盤に、権限統制と社内業務連携の層が加わると考えることができます。
Q9. 社内問い合わせの自動化で、特に注意すべきことは何ですか?
A. 問い合わせ履歴と回答根拠が関連付けられていない状態で、AIへ回答を任せないことです。
回答の根拠が確認できなければ、担当者による再確認が必要になり、二次対応が増える可能性があります。まずはFAQ、根拠文書、担当部門、更新日、有効期間などを構造化することが重要です。
Q10. AI活用を前提にすると、社内ポータル構築が難しくなりませんか?
A. 難しくなるというより、社内ポータルを整備する目的が明確になります。
単なる情報掲載や公開作業の効率化ではなく、「AIが社内業務で機能するための内部情報基盤をつくる」という目的が加わることで、正本管理、メタデータ、権限、承認、APIを整備する意義を社内で共有しやすくなります。
AIエージェント時代のイントラネット・社内ポータル構築をご検討中の方へ
AIエージェントを社内ポータルで活用するには、AIそのものだけでなく、社内コンテンツ、文書、版、メタデータ、アクセス権、承認、APIなどを整理した内部情報基盤が重要です。
GBSでは、イントラネット・社内ポータルの構築や移行、アクセス権・ガバナンス設計、API連携、運用自動化、AIエージェントを見据えた情報設計・業務設計についてご相談いただけます。
関連ページもご覧ください
イントラネット・社内ポータルの具体的な構築支援や、AIエージェント導入・業務自動化については、以下のページもあわせてご覧ください。
参考情報
大規模なWebサイト運営において、AIエージェントへの期待が高まっています。アクセス解析の自動化、競合調査、情報設計、デザイン制作、コーディング、CMSとのAPI連携による配信自動化まで、Web制作・運用の現場でAIを使いたいという声は確実に増えています。
ただし、ここで重要なのは「AIツールを導入すれば制作・運用が変わる」という単純な話ではないことです。大規模サイトの実務では、AIエージェントが何を参照し、どのコンテンツを根拠に答え、どこまでサイト構造と配信文脈を理解できるかが成果を左右します。
GBSは、AIエージェント時代のCMSをコンテンツを公開するための仕組みとしてではなく、AIエージェントが制作・運用で活躍するためのコンテンツ情報基盤として捉えるべきだと考えています。
ページ、コンポーネント、メタデータ、訳語、版、承認、配信先が整理され、信頼できるデータとして管理されていなければ、AIは現場で使える成果を返せません。逆に言えば、コンテンツ情報基盤が整っていれば、AIエージェントは単なる文章生成ツールではなく、戦略立案から設計、デザイン、実装、運用改善までを実務として前に進める存在になれます。

前回の「AIエージェント時代のPLM」では、製造業の製品情報基盤をテーマに、「AIエージェントが実務で活躍するには、まず情報基盤が整っていなければならない」という視点を示しました。本記事は、その視点を大規模Webサイト・CMS基盤に拡張するものです。製造業であれWeb運用であれ、AIエージェントが価値を出す本質は「AIが自然な文章を返すこと」ではなく、「業務に必要な情報へ適切にアクセスし、活用できること」にあります。
AIエージェントがWeb制作・運用で注目される背景には、デジタル体験の複雑化があります。公開スピードの要求は高まる一方で、サイトは多言語・多ブランド・多チャネル化し、部門をまたぐコンテンツ調整は増え、コンテンツ資産は散在し、ベテラン編集者の知識継承も課題になっています。
これまでのように、人がアクセスデータを読み、競合を調べ、構成を描き、デザインを作り、コードを書き、CMSに入力して公開するだけでは、スピードにも再現性にも限界があります。そこで期待されているのが、必要な情報を横断的に探し、文脈に応じて整理し、次のアクションにつながる形で支援するAIエージェントです。
特に大規模サイトでは、単なるチャット機能ではなく、コンテンツ、アクセスデータ、デザインシステム、コード、CMSといった複数の情報源をつなぎながら、現場の判断と作業を支援することが求められます。
AIだけでは業務改善できない理由
GBSは、AI単体では業務改善できないと考えています。なぜなら、AIの性能が高くても、参照するコンテンツとデータが整理されていなければ、現場で使える成果にはならないからです。
たとえば、次のような問いは大規模サイト運営では日常的に発生します。
- このキャンペーンページはどのコンテンツモデルを基に作られているのか
- 同じ訴求のランディングページは過去に存在したか
- この見出し文案はどのブランドガイドライン・訳語に従うべきか
- 直近のアクセス低下はどのページ群・どの流入経路で起きているか
- 現在公開すべき正しい版のコンテンツはどれか
これらに答えるためには、AIそのものよりも先に、コンテンツの構造と関係性が整っていなければなりません。ページ、コンポーネント、メタデータ、訳語、版、配信先、アクセスデータが分断されたままでは、AIは断片的な補助しかできません。
ChatGPTのような生成AIも同様です。生成AIは非常に有力な技術ですが、単体で導入しただけではWeb運用DXは前進しません。実務で使うには、CMS、アクセス解析、PIM/MDM、翻訳管理、承認ワークフローなどとAPI連携し、必要な文脈と根拠を持たせる必要があります。OpenAI APIも、エージェント構築においてはコンテキスト、ツール、業務システム連携が重要であることを示しています。
つまり、AIエージェントを導入する前に問うべきなのは、「どのAIを使うか」だけではありません。まず問うべきなのは、AIが使うべきコンテンツとデータが整理されているかです。
AIエージェントを支えるCMSという考え方
ここでCMSの役割が変わります。これまでCMSは、コンテンツ作成、承認、公開、配信の仕組みとして語られることが一般的でした。もちろんそれらは今後も重要です。
しかしAIエージェント時代には、CMSを単なる公開システムとしてではなく、AIエージェントが安全かつ実務的に使えるコンテンツ情報基盤として捉える必要があります。
CMSが重要なのは、コンテンツを集めるからではありません。どのコンテンツが正本なのか、どの版が有効なのか、誰が参照できるのか、どのコンテンツがどのチャネルに配信されるのか、といった業務文脈を持って管理できるからです。AIエージェントに必要なのは大量のコンテンツではなく、文脈付きで信頼できるコンテンツです。
この意味で、CMSは「コンテンツ公開システム」から「AIエージェントの情報基盤」へと、その価値の見え方を変えつつあります。
- 正しいコンテンツモデルにAIがアクセスできること
- ページ・コンポーネント・メタデータが関連付けられていること
- 版の前後関係と公開履歴が追えること
- サイト・ページ・コンポーネント・訳語・人の関係がたどれること
- 権限や承認ルールを守ったままAIが利用できること
こうした状態が整って初めて、AIエージェントは「答えるAI」ではなく、「制作・運用を前に進めるAI」になります。
世界のCMS・Web市場も同じ方向へ進んでいる
これはGBSだけの考え方ではありません。世界のCMSベンダー各社も、表現は異なっていても、AIを単体機能としてではなく、構造化コンテンツとAPIを前提に活用する方向へ進めています。
Contentfulは、AI Content Type GeneratorやAI Image Taggingを通じて、コンテンツモデル設計やメタデータ付与をAIで支援する考え方を示しています。これは、AIが場当たり的に文章を作るのではなく、構造化されたコンテンツ基盤の上で動くべきだという典型例です。
Sanityは、コンテンツを構造化データとして扱い、Content Lakeを通じてクエリ可能なコンテンツ基盤を提供します。AIがコンテンツを「文書」としてではなく「データ」として扱えることが、エージェント時代の前提になります。StoryblokやStrapiなども、APIファーストでコンテンツを構造化・再利用可能にする方向で同じ潮流にあります。
Web解析の領域でも流れは同じです。AdobeはAdobe AnalyticsのAI機能やAdobe Senseiを通じて、顧客データの理解、予測、コンテンツ最適化を支援する方向を示しています。Google Analytics 4(GA4)も予測指標や異常検出を標準搭載しており、Web解析そのものがAI前提の領域になりつつあります。
デザイン・実装の領域でも同様です。Figma AIはFigma agentを通じてデザイン方向の生成や画像編集、ファイル検索を支援し、Cursor、GitHub Copilot、DevinなどのAIコーディングエージェントは、コードベース全体を文脈として実装・テスト・修正まで扱う方向へ進んでいます。
つまり市場全体は、「AI搭載CMS」という表現を超えて、AIが活躍できるコンテンツ情報基盤をどう作るかという方向へ進みつつあります。GBSが打ち出したいメッセージは、この流れと本質的に重なっています。
AIエージェント活用例
Web戦略立案(アクセス解析の自動化)
AIエージェントは、アクセス解析の「数字を見る」作業を「課題を見つけ、次の一手を提示する」作業へ変える可能性を持っています。GA4やAdobe AnalyticsのデータをAIが自律的に読み、流入経路別の改善余地、離脱ポイント、CV低下要因を抽出し、施策の優先度付けまで行うことが想定されます。ただし前提になるのは、計測設計(イベント、コンバージョン定義、ディメンション)が整備され、データがAIにとって意味を持つ構造で取得されていることです。計測設計が曖昧なままAIに解析を任せると、数字は出ても判断の根拠が揺らぎ、施策に結びません。
情報設計(IA)
大規模サイトの情報設計は、AIエージェントが価値を出しやすい領域です。既存コンテンツの棚卸し、グローバルナビの再構成、URL設計、コンテンツモデルの定義、類似ページの統合候補抽出などは、実務での有効性が高いテーマです。しかし実際には、コンテンツがページ単位でしか管理されておらず、タイプ、属性、関連、版がモデリングされていなければ、AIは「それっぽい構成案」を出すにとどまり、再利用や横展開には使えません。
デザイン
デザイン制作では、Figma AI等を活用し、ブランドガイドラインに沿ったデザイン方向の生成、バリエーション展開、画像編集、デザインシステムのコンポーネント整備まで支援できます。ただし前提になるのは、デザインシステム(カラー、タイポグラフィ、コンポーネント、トーン&マナー)が明文化され、コードと同期していることです。ガイドラインが属人化した状態では、AIが生成するデザインはブレやすく、実装にそのまま使えません。
コーディング
コーディングでは、Cursor、GitHub Copilot、DevinなどのAIコーディングエージェントが、コンポーネント実装、テストコード生成、リファクタリング、本番障害の修正までを担うようになっています。ただし前提になるのは、コードベースがコンポーネント粒度で整理され、デザインシステムと対応し、CMSのコンポーネントモデルと一致していることです。UIとCMSの構造がずれたままだと、AIが書いたコードをCMSに載せ直す手戻りが発生し、自動化の効果が相殺されます。
CMSとのAPI接続
CMSとのAPI接続は、AIエージェントを「作って終わり」から「運用し続ける」存在にする鍵です。ヘッドレスCMSのAPIを通じて、AIがコンテンツの取得・更新・公開を自動化し、アクセス解析の結果からページ改善案を生成し、承認フローを経て配信するといったループが構成できます。ただし前提になるのは、CMSがAPIファーストで、コンテンツモデル、webhook、権限・承認APIを備えていることです。APIが整備されていないCMSにAIを載せても、AIがコンテンツを「読む」ことはできても「書いて出す」ことはできません。
AIエージェント時代にCMS基盤整備を考えるポイント
AIエージェント前提で大規模サイト/CMS基盤整備を考えるなら、機能一覧やパッケージ比較だけでは不十分です。重要なのは、「将来、AIが使えるコンテンツ情報基盤になっているか」という視点です。
1. コンテンツの正本をどこに置くか
ページ、コンポーネント、メタデータ、訳語、画像、配信先の正本管理を曖昧にしたままAIを載せても、成果の信頼性は上がりません。まずはコンテンツ管理の中心を定義することが必要です。
2. 構造化コンテンツと非構造化コンテンツを分断しないか
AIエージェントは、コンテンツモデルのような構造化データだけでなく、PDF、Word、画像、映像、議事録などの非構造化データも横断して価値を出します。両者を関連付けて扱えるCMS設計が重要です。
3. コンテンツモデリングがAIで再利用可能か
ページを「一枚もの」として管理するか、コンテンツモデルとコンポーネントに分解して再利用可能にするかは、AI活用の効率を大きく左右します。同じ訴求を多チャネル・多ブランドに展開する場合、構造化モデリングが前提になります。
4. 版管理・承認・権限・トレーサビリティを保ったままAIが使えるか
大規模サイトでAIを使ううえでは、便利さ以上に統制が重要です。誰が何を公開できるか、どの版を根拠にしたか、どの改善案がどのデータに基づくかを担保できることが必須です。
AIの権限管理とあわせて、利用するAI環境の管理も必要です
AIエージェントへ適切な権限を設定していても、担当者が個人契約の生成AIへ企業情報を入力していれば、企業側で利用状況や情報保持を管理できません。AI活用が広がるほど、BYOAI・シャドーAIを含む利用環境全体のガバナンスが重要になります。
BYOAI・シャドーAIのリスクと対策を読む →
5. マルチチャネル配信・API連携が可能か
AIエージェントは単一チャネル内より、Web、アプリ、メール、外部サービスをまたいだ時に真価を発揮します。CMSを核に、配信先、PIM/MDM、翻訳管理、MA/CRMとの連携を見据えたアーキテクチャが必要です。
PIM(Product Information Management)は、商品名、仕様、画像、説明文などの商品情報を一元管理し、Webサイト、EC、アプリ、マーケットプレイスなど複数チャネルへの配信を支える仕組みです。大規模なWeb基盤では、CMSだけですべての商品情報を管理するのではなく、PIMを商品情報の正本、CMSをコンテンツや表現・ページ構成の管理基盤として役割分担し、APIで連携する構成も考えられます。
6. API連携や将来のAI拡張が可能か
AIコーディングエージェントやAIデザインツールを活用するには、将来的なAPI連携、webhook、検索基盤、RAGなどの接続性も重要になります。今の運用課題だけでなく、将来のAI活用余地を見越してCMSを設計すべきです。
7. Fit to Standardだけで終わらないか
標準機能に業務を合わせることは依然として重要です。しかし、AIエージェント時代には、その標準化が「AIが読める・つながる・再利用できる」状態につながっているかまで問われます。これからのCMS基盤整備では、Fit to Standardに加えて、Fit to AIの視点が必要です。
GBSがご支援できること
GBSは、大規模CMS基盤整備を単なるシステム移行テーマではなく、Web運用DXを支えるコンテンツ情報基盤づくりとしてご支援します。AIエージェントを入れること自体が目的ではなく、AIエージェントが制作・運用で機能するためのコンテンツ設計、情報設計、API設計、運用設計まで含めて考えることが重要です。
- CMS基盤構築・移行支援:現状コンテンツの棚卸し、コンテンツモデリング、版・承認・権限設計、ヘッドレス/composable移行の構想策定
- headless CMS活用支援:Contentful、Sanity、StoryblokなどAPIファーストのheadless CMSを活用した配信基盤の設計・構築、マルチチャネル配信基盤の整備
- API連携・自動化支援:CMSとアクセス解析、PIM/MDM、翻訳管理、MA/CRMをつなぐAPI・webhook設計、配信・改善ループの自動化
- AIエージェントを見据えた情報設計:コンテンツの構造化、メタデータ設計、検索性・再利用性の向上、AI活用を見越したデータ整備・業務設計
重要なのは、特定のAIツールを先に決めることではありません。まず、自社のコンテンツ、コンテンツモデル、版、承認、APIが、AIエージェントにとって使える状態にあるかを見極めることです。
GBSが考えるこれからのCMSは、コンテンツを公開するためだけのものではありません。AIエージェントが、戦略立案、設計、デザイン、実装、運用改善にまたがって活躍するための基盤です。
Fit to Standardから、Fit to AIへ。
この視点でCMS基盤を見直すことが、これからのWeb運用DXにおける競争力の差につながります。
よくあるご質問
生成AIを導入するだけでは、なぜWeb運用の自動化につながらないのですか。
生成AIは、文章の作成や要約、分析などには活用できますが、それだけでは実際のWeb運用プロセスとはつながりません。CMS、アクセス解析、PIM/MDM、翻訳管理、承認ワークフローなどのシステムやデータと連携し、どの情報を参照し、どの処理を実行し、どこで人が確認するのかを設計することで、AIを実際の業務フローに組み込めるようになります。
なぜコンテンツモデリングがAIエージェント活用で重要なのですか。
AIがコンテンツを適切に検索・再利用・更新するためには、単にページや文章が保存されているだけでなく、「製品」「サービス」「事例」「ニュース」などの情報がどのような構造を持ち、互いにどう関連しているかを把握できることが重要です。コンテンツモデルを整理しておくことで、ページ間の関係や再利用範囲、配信先などをAIが判断しやすくなり、Webサイトだけでなく複数チャネルへの展開にもつなげやすくなります。
CMSとPIMはどのように使い分ければよいですか。
PIM(Product Information Management)は、商品名、仕様、画像、説明文、分類などの商品情報を一元管理し、Webサイト、EC、アプリ、マーケットプレイスなど複数チャネルへの展開を支える仕組みです。一方、CMSはWebページや記事などのコンテンツ作成・管理・公開を主に担います。大規模なWeb基盤では、商品情報をPIMで管理し、その情報をAPI等でCMSへ連携してページやコンテンツとして利用するなど、それぞれの役割を分けて構成することがあります。
既存のCMSを残したまま、AIエージェントを導入できますか。
可能です。AI活用のために、必ずしもCMSを全面的に入れ替えたり、ヘッドレスCMSへ移行したりする必要はありません。まず確認すべきなのは、既存CMSが必要なコンテンツや機能へAPI等でアクセスできるか、権限や承認、版管理を適切に制御できるかという点です。既存環境を活かしながら必要な部分からAIと接続し、段階的に基盤を整備する方法も検討できます。
ページやPDFなどの既存コンテンツが大量にあっても、AI活用を始められますか。
可能ですが、AIに大量のコンテンツをそのまま参照させるだけでは十分ではありません。古い版と新しい版の区別、メタデータ、コンテンツ同士の関連付け、公開範囲や権限などを整理し、どの情報を正しい情報源として扱うのかを明確にすることが重要です。既存コンテンツの棚卸しや整理と並行して、対象範囲を限定したPoCから始める方法もあります。
AIによるコンテンツ生成・更新では、どこまで自動化し、どこに人の承認を残すべきですか。
すべてをAIに任せる必要はありません。例えば、情報収集、下書き作成、既存コンテンツとの差分確認、CMSへの登録まではAIで支援し、最終確認や公開承認は人が行う、といった役割分担が考えられます。どこまで自動化するかは、コンテンツの重要度、誤りが生じた場合の影響、権限、承認ルールなどに応じて決めます。特に本番運用では、誰が何を承認したかを確認できるログや、必要に応じて処理を止められる仕組みも重要です。
AIエージェント時代の大規模Webサイト・CMS基盤整備をご検討中の方へ
AIエージェントをWeb制作・運用で活用するには、AIそのものだけでなく、コンテンツモデル・版・メタデータ・APIなどを整理したコンテンツ情報基盤が重要です。
GBSでは、大規模CMS基盤構築・移行支援、headless CMS活用、API連携・自動化、AIエージェントを見据えたコンテンツ設計・業務設計までご相談いただけます。
関連ページもご覧ください
大規模Webサイトの再構築、CMS導入、運用ガバナンス整備については、大規模Webサイト・CMS基盤整備をご覧ください。
AIエージェント時代のCMS基盤を具体的に検討する際は、AIソリューション、大規模Webサイト運用の課題、AIエージェント時代のPLMに関する各ページもあわせてご覧ください。
参考情報
製造業でAIエージェントへの期待が高まっています。検索、要約、問い合わせ対応といった補助業務だけでなく、BOM確認、設計変更の影響把握、図面や技術文書の横断検索、過去案件の再利用、プロジェクト進捗の把握まで、設計・開発の現場でAIを使いたいという声は確実に増えています。
ただし、ここで重要なのは「AIを導入すれば業務が変わる」という単純な話ではないことです。製造業の実務では、AIエージェントが何を参照し、どの情報を根拠に答え、どこまで業務文脈を理解できるかが成果を左右します。
GBSは、AIエージェント時代のPLMを設計情報管理のための仕組みとしてではなく、AIエージェントが業務で活躍するための製品情報基盤として捉えるべきだと考えています。こうした考え方は、近年「Agentic PLM(エージェンティックPLM)」と呼ばれることもあります。
BOM、図面、文書、要求仕様、設計変更、プロジェクト情報などが整理され、信頼できるデータとして管理されていなければ、AIは現場で使える答えを返せません。逆に言えば、製品情報管理が整っていれば、AIエージェントは単なる会話ツールではなく、設計・開発・製造の実務を前に進める存在になれます。

AIエージェントが製造業で注目される理由
AIエージェントが製造業で注目される背景には、設計・開発業務の複雑化があります。開発スピードの要求は高まる一方で、製品は多品種化し、部門横断の調整は増え、技術情報は散在し、ベテランの知識継承も課題になっています。
これまでのように、人が必要な情報を探し、読み比べ、関係部門に確認しながら判断するだけでは、スピードにも再現性にも限界があります。そこで期待されているのが、必要な情報を横断的に探し、文脈に応じて整理し、次のアクションにつながる形で支援するAIエージェントです。
特に製造業では、単なるチャット機能ではなく、設計・製造・品質・保守にまたがる情報をつなぎながら、現場の判断を支援することが求められます。つまり、製造業におけるAIエージェントの本質は、「AIが自然な文章を返すこと」ではなく、「業務に必要な製品情報へ適切にアクセスし、活用できること」にあります。
AIだけでは業務改善できない理由
GBSは、AI単体では業務改善できないと考えています。なぜなら、AIの性能が高くても、参照する情報が整理されていなければ、現場で使える答えにはならないからです。
たとえば、次のような問いは製造業では日常的に発生します。
- この設計変更はどのBOMに影響するのか
- 類似部品は過去に存在したか
- この要求仕様はどの図面・試験項目・文書と関係しているか
- 過去案件ではどのような判断がされていたか
- 現在参照すべき正しい版はどれか
これらに答えるためには、AIそのものよりも先に、製品情報の構造と関係性が整っていなければなりません。BOM、図面、仕様書、変更履歴、要求仕様、プロジェクト情報が分断されたままでは、AIは断片的な補助しかできません。
ChatGPTのような生成AIも同様です。生成AIは非常に有力な技術ですが、単体で導入しただけでは製造業DXは前進しません。実務で使うには、PLMデータ、ERP、文書管理、BOM、設計変更情報などとAPI連携し、必要な文脈と根拠を持たせる必要があります。OpenAI APIも、エージェント構築においてはコンテキスト、ツール、業務システム連携が重要であることを示しています。
つまり、AIエージェントを導入する前に問うべきなのは、「どのAIを使うか」だけではありません。まず問うべきなのは、AIが使うべき製品情報が整理されているかです。
Agentic PLMとは?
近年、AIエージェントとPLMを組み合わせた考え方として、「Agentic PLM(エージェンティックPLM)」という言葉が使われ始めています。
Agentic PLMとは、PLMに蓄積されたBOM、図面、仕様書、要求仕様、設計変更、プロジェクト情報などをAIエージェントが参照し、単に情報を検索・要約するだけでなく、業務の文脈を踏まえた分析や判断支援、次のアクションにつなげていく考え方です。
従来のPLMが「製品情報を正しく管理する仕組み」だとすれば、Agentic PLMでは、その製品情報をAIエージェントが業務で活用できる状態にすることまでが重要になります。
Agentic PLMのポイント
AIそのものをPLMに追加することが目的ではありません。AIエージェントが正しいBOMや最新版の図面、変更履歴、要求仕様などを根拠として、安全かつ適切に業務を支援できる製品情報基盤を整えることが重要です。
そのため、Agentic PLMを実現するうえでは、AIモデルの性能だけでなく、製品情報の正本管理、版管理、データ間の関係性、アクセス権限、承認プロセス、APIによる業務システムとの連携などが重要になります。
GBSでは、この考え方を「AIエージェント時代のPLM」として捉えています。PLMを単なる設計情報の保管場所ではなく、AIエージェントが設計・開発・製造・品質・保守の業務で活躍するための信頼できる製品情報基盤へ進化させることが重要だと考えています。
AIエージェントを支えるPLMという考え方
ここでPLMの役割が変わります。これまでPLMは、設計情報管理、図面管理、部品表管理、変更管理の仕組みとして語られることが一般的でした。もちろんそれらは今後も重要です。
しかしAIエージェント時代には、PLMを単なる管理システムとしてではなく、AIエージェントが安全かつ実務的に使える情報基盤として捉える必要があります。
PLMが重要なのは、情報を集めるからではありません。どの情報が正本なのか、どの版が有効なのか、誰が参照できるのか、どの変更が何に影響するのか、といった業務文脈を持って管理できるからです。AIエージェントに必要なのは大量データではなく、文脈付きで信頼できるデータです。
この意味で、PLMは「設計情報管理」から「AIエージェントの情報基盤」へと、その価値の見え方を変えつつあります。
- 正しいBOMにAIがアクセスできること
- 図面・仕様書・要求仕様が関連付けられていること
- 設計変更の前後関係と影響範囲が追えること
- 案件・製品・部品・文書・人の関係がたどれること
- 権限や承認ルールを守ったままAIが利用できること
こうした状態が整って初めて、AIエージェントは「答えるAI」ではなく、「業務を前に進めるAI」になります。
世界のPLM市場も同じ方向へ進んでいる
これはGBSだけの考え方ではありません。世界のPLMベンダー各社も、表現は異なっていても、AIを単体機能としてではなく、PLMやデジタルスレッド上の情報を活用する方向へ進めています。
PTCはWindchill AIを、PLMワークフローに埋め込まれたAIとして位置づけ、製品データの理解、定型作業の自動化、意思決定支援、さらに「agentic digital thread」という考え方まで打ち出しています。AIが価値を出す前提として、信頼できる製品データとデジタルスレッドがあることを明確にしています。
SiemensのTeamcenter Copilotは、PLM内の知識ベース、セマンティック検索、RAG、権限制御を通じて、企業内の文書や製品情報に根ざした回答を返す考え方を示しています。これは、AIが外部の一般知識ではなく、自社のPLMデータを根拠に動くべきだという典型例です。加えて、Siemens Industrial Copilotも、設計・計画から運用・保守まで産業バリューチェーン全体を支援する方向性を示しています。
Arasは、構造化データと非構造化データをまたぐAI支援検索や、自然言語での知識活用を打ち出しています。PLMとデジタルスレッドを基盤に、製品データへのアクセスや解釈をより実務的にする方向です。
Dassault Systèmesは、AIをVirtual TwinやOntology、Generative Knowledge & Know-Howと結びつけ、データを検証可能な知識へ変える方向を示しています。ここでも重要なのは、AI単体ではなく、モデル、データ、文脈を結びつける基盤的な考え方です。
CONTACT SoftwareのFourier AIも、製品ライフサイクル全体にAIを埋め込むための基盤として位置づけられています。BOM処理や要件管理など、Digital Thread上の各ポイントでAIを活用する考え方は、まさにAIエージェント時代のPLMの一つの方向性といえます。
つまり市場全体は、「AI搭載PLM」という表現を超えて、AIが活躍できる製品情報基盤をどう作るかという方向へ進みつつあります。GBSが打ち出したいメッセージは、この流れと本質的に重なっています。
AIエージェント活用例
BOM活用
AIエージェントは、部品表を読むだけでなく、構成差分の把握、類似部品の再利用候補抽出、調達影響の確認、変更候補の洗い出しまで支援できます。ただし前提になるのは、BOMが統一された粒度・属性・版管理で整備されていることです。BOMが部門ごとに分断され、名称ゆれや属性欠落が多い状態では、AIは正しい再利用提案も影響分析もできません。
多品種・多仕様のBOM管理について
製品の仕様やオプションが増える場合は、BOMの粒度や版管理だけでなく、製品バリエーションをどのように表現・管理するかも重要になります。
製品ファミリー全体の構成候補を管理する150% BOMと、特定仕様の100% BOMの違い、構成ルールの考え方については、別のコラムで詳しく解説しています。
150% BOMとは?バリエーション管理・100% BOMとの違いを解説 →
設計変更
設計変更は、AIエージェントが価値を出しやすい領域です。変更要求の要約、関連文書の収集、影響対象部品・図面・試験項目の抽出、過去類似案件の提示などは、実務での有効性が高いテーマです。しかし実際には、変更理由、承認履歴、変更前後の差分、関連成果物がPLM上で一貫して管理されていなければ、AIは部分的な補助しかできません。
図面検索
図面検索では、「品番を知っている人だけが探せる」状態から脱却できるかが重要です。AIエージェントが自然言語で「この機能を持つ部品」「過去に似た構造の図面」「この規格に関わる設計例」を見つけられるようになると、設計初期の検討スピードは大きく変わります。ただし、図面そのものだけでなく、メタデータ、版、関連仕様、変更履歴までひも付いていなければ、検索結果の信頼性は上がりません。
技術文書
仕様書、試験規格、作業標準、品質文書、過去トラブル報告書など、製造業には「あるが見つからない」「読めるが使い切れない」文書が大量にあります。知識ベース化されたPLM文書に対してAIが対話的に回答できれば、ベテラン依存の軽減や立ち上がり期間短縮に効果があります。逆に、文書が散在し、どれが正なのか分からない状態では、AIは誤誘導のリスクを高めます。
過去案件の再利用
AIエージェントは、過去案件を「検索対象」から「再利用資産」へ変える可能性を持っています。類似製品、類似部品、類似要求、過去の不具合対応、顧客別カスタマイズ履歴を横断して参照できれば、設計の初手が変わります。ですが、案件情報、成果物、変更履歴、技術判断の根拠がPLMや関連システムでつながっていないと、再利用は結局人の記憶頼みのままです。
プロジェクト管理
プロジェクト管理でも、AIエージェントは進捗報告の要約、遅延要因の抽出、未完了タスクと設計変更の関連把握、会議前の論点整理などで役立ちます。ただし、タスク、成果物、承認、課題、設計変更が別々のツールで管理されていて関係性が見えない場合、AIは状況説明の補助にはなっても、意思決定支援までは届きません。
AIエージェント時代にPLM導入を考えるポイント
AIエージェント前提でPLM導入を考えるなら、機能一覧やパッケージ比較だけでは不十分です。重要なのは、「将来、AIが使える情報基盤になっているか」という視点です。
1. 製品情報の正本をどこに置くか
BOM、図面、仕様書、要求仕様、変更情報の正本管理を曖昧にしたままAIを載せても、答えの信頼性は上がりません。まずは製品情報管理の中心を定義することが必要です。
2. 構造化データと非構造化データを分断しないか
AIエージェントは、BOMのような構造化データだけでなく、PDF、Word、図面、スキャン文書、議事録などの非構造化データも横断して価値を出します。両者を関連付けて扱えるPLM設計が重要です。
3. 設計変更を履歴ではなく知識として扱えるか
変更票を残すだけでなく、「なぜ変えたか」「どこに影響したか」「再発防止にどう生かすか」まで追える設計が、AIエージェント時代の変更管理には求められます。
4. 権限・承認・トレーサビリティを保ったままAIが使えるか
製造業でAIを使ううえでは、便利さ以上に統制が重要です。誰が何を見られるか、どの版を根拠にしたか、どの回答がどの情報源に基づくかを担保できることが必須です。
5. ERP、文書管理、品質、プロジェクト情報とつながるか
AIエージェントは単独システム内より、複数システムをまたいだ時に真価を発揮します。PLMを核に、ERP、QMS、文書管理、プロジェクト管理との連携を見据えたアーキテクチャが必要です。
6. API連携や将来のAI拡張が可能か
ChatGPTをはじめとする生成AIや各種AIエージェントを活用するには、将来的なAPI連携、検索基盤、RAGなどの接続性も重要になります。今の運用課題だけでなく、将来のAI活用余地を見越してPLMを設計すべきです。
7. Fit to Standardだけで終わらないか
標準機能に業務を合わせることは依然として重要です。しかし、AIエージェント時代には、その標準化が「AIが読める・つながる・再利用できる」状態につながっているかまで問われます。これからのPLM導入では、Fit to Standardに加えて、Fit to AIの視点が必要です。
GBSがご支援できること
GBSは、PLMを単なるシステム導入テーマではなく、製造業DXを支える製品情報基盤づくりとしてご支援します。AIエージェントを入れること自体が目的ではなく、AIエージェントが実務で機能するための情報設計、業務設計、運用設計まで含めて考えることが重要です。
- PLM導入支援:現状業務の整理、製品情報の棚卸し、BOM・設計変更・文書管理の要件定義、導入構想策定
- CONTACT Software活用支援:PLM基盤構築、デジタルスレッド整備、将来のAI活用を見据えた情報設計
- CIM Database活用支援:設計情報・技術情報の蓄積と再利用性向上、検索性改善、業務知識の資産化
CONTACT Fourier AIのように、PLM上の情報を前提にAIを活用する選択肢は今後さらに増えていきます。ただし重要なのは、特定のAI製品を先に決めることではありません。まず、自社のBOM、図面、文書、要求仕様、設計変更、案件情報が、AIエージェントにとって使える状態にあるかを見極めることです。
GBSが考えるこれからのPLMは、設計情報を管理するためだけのものではありません。AIエージェントが、設計、開発、製造、品質、保守にまたがって活躍するための基盤です。
Fit to Standardから、Fit to AIへ。
この視点でPLMを見直すことが、これからの製造業DXにおける競争力の差につながります。
FAQ
Q1. AIエージェントがあれば、PLMは不要になるのでしょうか。
A. いいえ。むしろ逆です。AIエージェントが実務で価値を出すには、信頼できる製品情報基盤が必要です。PLMは、AIが参照する情報の正本・版・関係性・権限を管理する役割を担います。
Q2. ChatGPTを導入すれば、設計業務はすぐ効率化できますか。
A. 単体導入だけでは限定的です。ChatGPTや生成AIは有力ですが、PLM、ERP、文書管理、BOM、変更管理とAPI連携し、業務文脈を持たせて初めてAIエージェントとして機能します。
Q3. なぜBOMがAI活用の鍵になるのですか。
A. BOMは製品構成の中心情報だからです。部品間の関係、影響範囲、再利用候補、原価や調達への波及など、多くの判断がBOMを起点に発生します。BOM品質が低いとAIの提案精度も下がります。
Q4. 図面やPDFが大量にあります。これでもAI活用は可能ですか。
A. 可能ですが、整理が前提です。版管理、属性付与、関連情報とのひも付け、OCRや検索性改善が必要です。文書が散在したままでは、AIは「見つけたように見えて、使えない」状態になりがちです。
Q5. AIエージェントと生成AIは同じ意味ですか。
A. 厳密には異なります。生成AIは文章生成や要約などのモデル機能を指すことが多く、AIエージェントはそこに検索、ツール実行、システム連携、業務フロー遂行まで含めた実行主体を指します。
Q6. Agentic PLMとは何ですか?
A. Agentic PLMとは、PLMに蓄積されたBOM、図面、仕様書、設計変更、要求仕様などの製品情報をAIエージェントが活用し、検索や要約だけでなく、分析、判断支援、業務アクションにつなげていく考え方です。
重要なのは、AIをPLMに追加すること自体ではありません。AIエージェントが信頼できる製品情報を、適切な権限や承認ルールのもとで利用できるようにすることです。そのため、Agentic PLMでは、製品情報の正本管理、版管理、データ間の関係性、権限管理、API連携などが重要になります。
Q7. まずAIツールを入れてから、後でPLMを整えてもよいですか。
A. 一時的なPoCなら可能ですが、本番活用では限界が出やすいです。情報基盤が未整備だと、回答の根拠、更新追従、権限、トレーサビリティの問題が残ります。
Q8. AIエージェント時代のPLM導入では、どの部門が関与すべきですか。
A. 設計部門だけでなく、情報システム、DX推進、品質、製造技術、場合によっては経営層も含めた横断体制が望まれます。AI活用はシステム導入ではなく業務基盤再設計に近いテーマだからです。
Q9. デジタルスレッドとPLMはどう違うのですか。
A. PLMは製品情報を管理する基盤であり、デジタルスレッドはその情報を設計から製造、品質、保守までつなぐ考え方です。AIエージェントは、このつながりがあるほど高い価値を出しやすくなります。
Q10. CONTACT Fourier AIのようなAI基盤は、どのような企業に向いていますか。
A. 製品情報をPLM上で整備しながら、将来的にBOM、要件管理、文書活用、デジタルスレッド全体でAIを使いたい企業に向いています。ただし、先に情報基盤の整備方針を固めることが重要です。
Q11. PLM導入は、AI活用を前提にすると難しくなりませんか。
A. 難しくなるというより、目的が明確になります。単なる管理効率化ではなく、「AIが業務で機能するための情報基盤をつくる」という視点が加わるため、導入意義を社内で共有しやすくなります。
AIエージェント時代のPLM導入をご検討中の方へ
AIエージェントを業務で活用するには、AIそのものだけでなく、BOM・図面・文書・設計変更情報などを整理した製品情報基盤が重要です。
GBSでは、PLM導入支援、CONTACT Software / CIM Databaseの活用、AIエージェントを見据えたデータ整備・業務設計までご相談いただけます。
関連ページもご覧ください
PLMに関する基本的な考え方についてはPLMとは?をご覧ください。
AIエージェント時代のPLMを具体的に検討する際は、PLM導入支援、CONTACT Software、CIM Databaseの各ページもあわせてご覧ください。
参考情報
